
 Карточки
 Тесты


 Главная
 Курсы
 Подписка
ЕГЭ, Информатика: 27. Программирование: все задания

Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала абсолютную величину целой части произведения $P_x \times 10,000$, затем абсолютную величину целой части произведения $P_y \times 10,000$; сначала абсолютную величину целой части произведения $Q_x \times 10,000$, затем абсолютную величину целой части произведения $Q_y \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
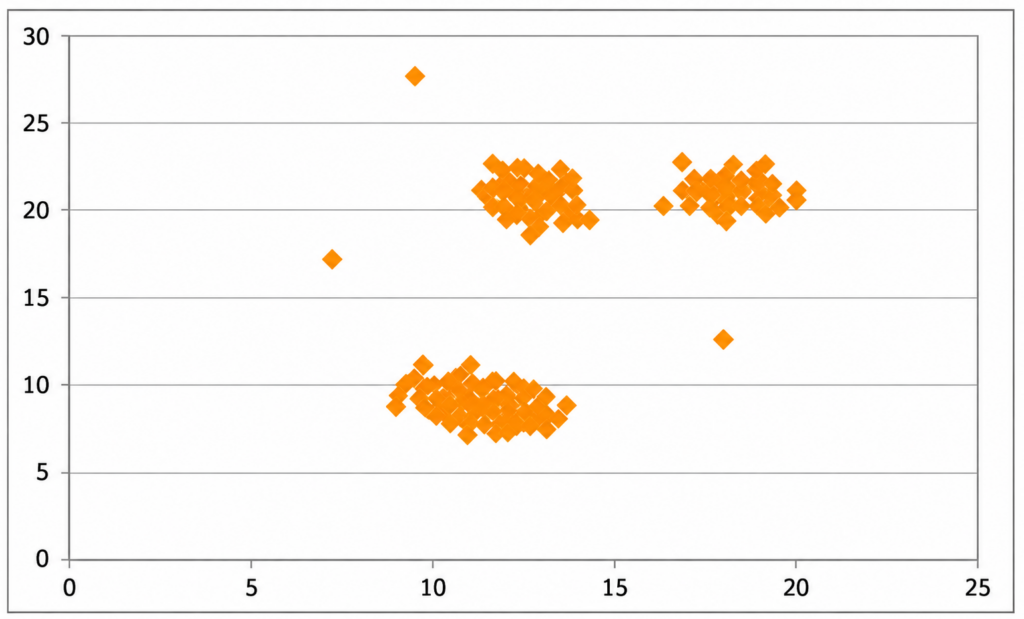
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и никакого хитрого алгоритма не требуется — нужно лишь найти «щели» между сгустками точек. Определение центра здесь геометрическое: это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Поэтому её ищут перебором по точкам кластера, а не считают как среднее арифметическое координат — это самая частая ошибка в этом задании.
Файл $А$. Первая строка — заголовок $X$ $Y$, данных $207$ точек. Разброс ординат сразу выдаёт структуру: один кластер лежит в полосе $y \in [5{,}64;\ 7{,}97]$, второй — в полосе $y \in [18{,}10;\ 20{,}91]$. Между ними огромный пустой промежуток, поэтому достаточно разделить точки условием $y < 12$. По абсциссам кластеры почти совпадают ($x \in [2{,}84;\ 4{,}34]$ и $x \in [4{,}07;\ 5{,}95]$), так что делить по $x$ было бы ошибкой. Размеры групп $77$ и $130$ точек, обе укладываются в прямоугольник $6 \times 4{,}5$ — проверка сходится.
Файл $Б$. Здесь глазами полосу уже не выделить: кластеры разнесены и по $x$, и по $y$. Надёжнее разбить точки на компоненты связности — объединять точки, отстоящие друг от друга меньше чем на $1$. Внутри плотного сгустка соседи всегда ближе этого порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Такой проход даёт группы размерами $397$, $133$, $74$ и три одиночные точки — это и есть три аномалии, о которых говорится в условии; они отбрасываются автоматически, потому что состоят из одной точки. Кластер с минимальным количеством точек — тот, где их $74$, с максимальным — где $397$.
import openpyxl, math

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

# файл А: два кластера разделены щелью по ординате
A = load('27-01_A.xlsx')
a1 = [p for p in A if p[1] < 12]
a2 = [p for p in A if p[1] >= 12]
c1, c2 = center(a1), center(a2)
Px, Py = (c1[0] + c2[0]) / 2, (c1[1] + c2[1]) / 2
print(abs(int(Px * 10000)), abs(int(Py * 10000)))

# файл Б: компоненты связности, одиночки — аномалии
def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

B = load('27-01_B.xlsx')
cs = sorted((c for c in clusters(B) if len(c) > 3), key=len)
b1, b2 = center(cs[0]), center(cs[-1])
Qx, Qy = b1[0] + b2[0], b1[1] + b2[1]
print(abs(int(Qx * 10000)), abs(int(Qy * 10000)))
Результаты для файла $А$. Центры кластеров: $(3{,}5602193;\ 6{,}8574664)$ и $(4{,}9372174;\ 19{,}5388034)$. Отсюда $P_x = (3{,}5602193 + 4{,}9372174) / 2 = 4{,}24871835$ и $P_y = (6{,}8574664 + 19{,}5388034) / 2 = 13{,}1981349$. После умножения на $10,000$ и отбрасывания дробной части получаем $42487$ и $131981$.
Результаты для файла $Б$. Всего $607$ точек, из них три аномальные. Центр самого маленького кластера ($74$ точки) — $(16{,}9328755;\ 22{,}607628)$, центр самого большого ($397$ точек) — $(10{,}1344184;\ 13{,}5931472)$. Складываем координаты: $Q_x = 16{,}9328755 + 10{,}1344184 = 27{,}0672939$ и $Q_y = 22{,}607628 + 13{,}5931472 = 36{,}2007752$, что даёт $270672$ и $362007$.
 20

Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала абсолютную величину целой части произведения $P_x \times 10,000$, затем абсолютную величину целой части произведения $P_y \times 10,000$; сначала абсолютную величину целой части произведения $Q_1 \times 10,000$, затем абсолютную величину целой части произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог нужно подбирать осмысленно и потом проверять результат: он должен дать ровно столько кластеров, сколько обещано в условии.
Файл $А$. Всего $217$ точек (первая строка — заголовок $X$ $Y$). Кластеры разнесены по ординате: один лежит в полосе $y \in [6{,}51;\ 10{,}42]$, второй — в полосе $y \in [22{,}63;\ 26{,}74]$, между ними пустота шириной больше $12$. Здесь важна тонкость: при пороге $1$ от нижнего кластера отрывается точка $(2{,}0197429;\ 6{,}5052367)$ — до ближайшего соседа у неё $1{,}03$. Но аномалий в файле $А$ по условию нет, а с этой точкой нижняя группа по-прежнему укладывается в прямоугольник ($3{,}65$ по $x$ и $3{,}91$ по $y$ против допустимых $4{,}5$ и $6$), так что точка принадлежит кластеру. Надёжнее просто разделить точки условием $y < 15$: получаются группы из $110$ и $107$ точек.
Файл $Б$. Здесь $617$ точек. Порог $1$ (или $1{,}5$) даёт группы размерами $419$, $107$, $88$ и три одиночные точки — это и есть обещанные аномалии. Проверка: у каждой из них ближайший сосед находится на расстоянии больше $23$, тогда как внутри любого кластера точки идут вплотную. Три настоящих кластера укладываются в прямоугольники нужного размера.
import openpyxl, math
from itertools import combinations

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

# файл А: два кластера разделены щелью по ординате
A = load('27-02_A.xlsx')
c1, c2 = center([p for p in A if p[1] < 15]), center([p for p in A if p[1] >= 15])
Px, Py = c1[0] + c2[0], c1[1] + c2[1]
print(abs(int(Px * 10000)), abs(int(Py * 10000)))

# файл Б: компоненты связности, одиночки — аномалии
B = load('27-02_B.xlsx')
cs = [center(c) for c in clusters(B) if len(c) > 3]
d = [math.dist(a, b) for a, b in combinations(cs, 2)]
print(abs(int(min(d) * 10000)), abs(int(max(d) * 10000)))
Результаты для файла $А$. Центры кластеров: $(3{,}6319192;\ 8{,}782799)$ и $(6{,}1168889;\ 24{,}8122646)$. Отсюда $P_x = 3{,}6319192 + 6{,}1168889 = 9{,}7488081$ и $P_y = 8{,}782799 + 24{,}8122646 = 33{,}5950636$. После умножения на $10,000$ и отбрасывания дробной части получаем $97488$ и $335950$.
Результаты для файла $Б$. Центры трёх кластеров: $(5{,}5317089;\ 24{,}5603028)$ для кластера из $419$ точек, $(8{,}4227338;\ 34{,}3897427)$ для кластера из $107$ точек и $(15{,}4888704;\ 34{,}9117814)$ для кластера из $88$ точек. Три попарных расстояния между ними равны $7{,}0853942$, $10{,}2457754$ и $14{,}3630837$. Значит, $Q_1 = 7{,}0853942$ (между вторым и третьим центрами) и $Q_2 = 14{,}3630837$, что даёт $70853$ и $143630$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала абсолютную величину целой части произведения $P_x \times 10,000$, затем абсолютную величину целой части произведения $P_y \times 10,000$; сначала абсолютную величину целой части произведения $Q_1 \times 10,000$, затем абсолютную величину целой части произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог подбираем и проверяем по результату: он должен дать ровно столько кластеров, сколько обещано в условии, и каждый кластер должен укладываться в прямоугольник заданного размера.
Файл $А$. Всего $215$ точек (первая строка — заголовок $X$ $Y$). Разбиение получается сразу и устойчиво к выбору порога: группы из $101$ и $114$ точек. Первая занимает область $x \in [2{,}26;\ 5{,}05]$, $y \in [6{,}69;\ 10{,}19]$, вторая — $x \in [5{,}38;\ 8{,}82]$, $y \in [21{,}92;\ 26{,}11]$. Обе укладываются в прямоугольник $6 \times 4{,}5$, между ними по ординате пустота больше $11$ — проверка сходится. Аномалий в файле $А$ нет, и лишних одиночных точек алгоритм действительно не находит.
Файл $Б$. Здесь $615$ точек. При пороге $1$ получается лишняя четвёртая одиночка — это не аномалия, а оторвавшаяся точка третьего кластера. Увеличив порог до $1{,}5$, получаем ровно то, что обещает условие: группы размерами $385$, $143$, $84$ и три одиночные точки. Что это именно аномалии, легко проверить: у каждой из них ближайший сосед находится на расстоянии больше $24$, тогда как внутри кластеров точки идут вплотную. Все три кластера укладываются в прямоугольник $6 \times 5$, например третий занимает $x \in [20{,}49;\ 23{,}37]$, $y \in [26{,}45;\ 30{,}75]$.
import openpyxl, math
from itertools import combinations

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-03_A.xlsx')
cs = [center(c) for c in clusters(A) if len(c) > 3]
Px, Py = sum(p[0] for p in cs), sum(p[1] for p in cs)
print(abs(int(Px * 10000)), abs(int(Py * 10000)))

B = load('27-03_B.xlsx')                  # одиночки отсеиваются как аномалии
cs = [center(c) for c in clusters(B) if len(c) > 3]
d = [math.dist(a, b) for a, b in combinations(cs, 2)]
print(abs(int(min(d) * 10000)), abs(int(max(d) * 10000)))
Результаты для файла $А$. Центры кластеров: $(3{,}646085;\ 8{,}281527)$ и $(7{,}0541856;\ 24{,}0926065)$. Отсюда $P_x = 3{,}646085 + 7{,}0541856 = 10{,}7002706$ и $P_y = 8{,}281527 + 24{,}0926065 = 32{,}3741335$. После умножения на $10,000$ и отбрасывания дробной части получаем $107002$ и $323741$.
Результаты для файла $Б$. Центры трёх кластеров: $(7{,}1388191;\ 26{,}5557487)$ для кластера из $385$ точек, $(16{,}993709;\ 31{,}636538)$ для кластера из $143$ точек и $(22{,}1529783;\ 28{,}820322)$ для кластера из $84$ точек. Три попарных расстояния между ними равны $5{,}8778510$, $11{,}0875279$ и $15{,}1839807$. Значит, $Q_1 = 5{,}8778510$ (между вторым и третьим центрами) и $Q_2 = 15{,}1839807$, что даёт $58778$ и $151839$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала абсолютную величину целой части произведения $P_x \times 10,000$, затем абсолютную величину целой части произведения $P_y \times 10,000$; сначала целую часть произведения $Q_1 \times 10,000$, затем целую часть произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
Обратите внимание: $P_x$ и $P_y$ здесь берутся независимо друг от друга — это минимум по абсциссам и минимум по ординатам, а не координаты одной и той же точки. В данном файле они случайно принадлежат одному центру, но полагаться на это нельзя.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог проверяем по результату: он должен дать ровно столько кластеров, сколько обещано в условии, и каждый должен укладываться в прямоугольник заданного размера.
Файл $А$. Всего $223$ точки (первая строка — заголовок $X$ $Y$). Разбиение устойчиво к выбору порога от $1$ до $2$: группы из $92$ и $131$ точки. Первая занимает область $x \in [5{,}47;\ 8{,}48]$, $y \in [11{,}46;\ 13{,}00]$, вторая — $x \in [2{,}09;\ 5{,}53]$, $y \in [5{,}29;\ 6{,}96]$. Обе укладываются в прямоугольник $6 \times 4{,}5$. Аномалий в файле $А$ нет, и лишних одиночных точек алгоритм не находит.
Файл $Б$. Здесь $623$ точки. Разбиение снова устойчиво: группы размерами $407$, $113$, $100$ и три одиночные точки — это и есть обещанные аномалии. Проверка: у каждой из них ближайший сосед находится на расстоянии больше $22$, тогда как внутри кластеров точки идут вплотную. Кластер с минимальным количеством точек — тот, где их $100$, с максимальным — где $407$; именно между их центрами и считается $Q_1$.
Для $Q_2$ нужно в каждом кластере найти самую далёкую от его центра точку и взять наибольшее из этих значений по всем кластерам. Здесь легко ошибиться и посчитать максимальное расстояние между любыми двумя точками кластера — в условии речь именно о расстоянии от центра.
import openpyxl, math

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-04_A.xlsx')
cs = [center(c) for c in clusters(A) if len(c) > 3]
Px, Py = min(p[0] for p in cs), min(p[1] for p in cs)
print(abs(int(Px * 10000)), abs(int(Py * 10000)))

B = load('27-04_B.xlsx')                  # одиночки отсеиваются как аномалии
cl = sorted((c for c in clusters(B) if len(c) > 3), key=len)
cen = [center(c) for c in cl]
Q1 = math.dist(cen[0], cen[-1])           # min и max по количеству точек
Q2 = max(max(math.dist(cn, p) for p in c) for c, cn in zip(cl, cen))
print(int(Q1 * 10000), int(Q2 * 10000))
Результаты для файла $А$. Центры кластеров: $(7{,}0391548;\ 12{,}3587258)$ и $(3{,}8471735;\ 6{,}1225014)$. Минимальная абсцисса $P_x = 3{,}8471735$, минимальная ордината $P_y = 6{,}1225014$. После умножения на $10,000$ и отбрасывания дробной части получаем $38471$ и $61225$.
Результаты для файла $Б$. Центры кластеров: $(21{,}3946551;\ 24{,}7510816)$ для кластера из $100$ точек, $(14{,}6275088;\ 23{,}5024317)$ для кластера из $113$ точек и $(11{,}555522;\ 14{,}5042082)$ для кластера из $407$ точек. Расстояние между центрами самого маленького и самого большого кластеров $Q_1 = 14{,}2058775$. Максимальные удаления точек от своего центра по кластерам: $2{,}2357$, $2{,}3039$ и $2{,}5300$, наибольшее из них $Q_2 = 2{,}5299752$. Умножаем на $10,000$ и берём целые части: $142058$ и $25299$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала целую часть абсолютного значения произведения $P_x \times 10,000$, затем целую часть абсолютного значения произведения $P_y \times 10,000$; сначала целую часть абсолютного значения произведения $Q_x \times 10,000$, затем целую часть абсолютного значения произведения $Q_y \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
Обратите внимание на две формулировки, которые легко прочесть невнимательно. Во-первых, $P_x$ и $P_y$ берутся независимо друг от друга — это максимум по абсциссам и максимум по ординатам, а не координаты одной точки. Во-вторых, для файла $Б$ считается разность, а не расстояние: берётся модуль результата, так что порядок вычитания на ответ не влияет.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог проверяем по результату: он должен дать ровно столько кластеров, сколько обещано в условии, и каждый должен укладываться в прямоугольник заданного размера.
Файл $А$. Всего $201$ точка (первая строка — заголовок $X$ $Y$). Разбиение устойчиво к выбору порога от $1$ до $2$: группы из $83$ и $118$ точек. Первая занимает область $x \in [2{,}78;\ 4{,}18]$, $y \in [3{,}96;\ 7{,}15]$, вторая — $x \in [4{,}18;\ 5{,}69]$, $y \in [16{,}66;\ 19{,}80]$. Обе укладываются в прямоугольник $6 \times 4{,}5$. По абсциссам кластеры почти совпадают, разделяет их именно ордината — делить по $x$ было бы ошибкой. Аномалий в файле $А$ нет, лишних одиночных точек алгоритм не находит.
Файл $Б$. Здесь $601$ точка. Разбиение снова устойчиво: группы размерами $372$, $127$, $99$ и три одиночные точки — это и есть обещанные аномалии. Проверка: у каждой из них ближайший сосед находится на расстоянии больше $22$, тогда как внутри кластеров точки идут вплотную. Кластер с минимальным количеством точек — тот, где их $99$, с максимальным — где $372$; разности координат считаются именно между их центрами.
import openpyxl, math

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-05_A.xlsx')
cs = [center(c) for c in clusters(A) if len(c) > 3]
Px, Py = max(p[0] for p in cs), max(p[1] for p in cs)
print(int(abs(Px * 10000)), int(abs(Py * 10000)))

B = load('27-05_B.xlsx')                  # одиночки отсеиваются как аномалии
cl = sorted((c for c in clusters(B) if len(c) > 3), key=len)
c_min, c_max = center(cl[0]), center(cl[-1])
Qx, Qy = c_min[0] - c_max[0], c_min[1] - c_max[1]
print(int(abs(Qx * 10000)), int(abs(Qy * 10000)))
Результаты для файла $А$. Центры кластеров: $(3{,}4396093;\ 5{,}7248664)$ и $(4{,}9959134;\ 18{,}2737359)$. Максимальная абсцисса $P_x = 4{,}9959134$, максимальная ордината $P_y = 18{,}2737359$. После умножения на $10,000$ и отбрасывания дробной части получаем $49959$ и $182737$.
Результаты для файла $Б$. Центры кластеров: $(18{,}5126688;\ 21{,}1251054)$ для кластера из $99$ точек, $(12{,}7758796;\ 20{,}719154)$ для кластера из $127$ точек и $(11{,}5299174;\ 8{,}8858558)$ для кластера из $372$ точек. Считаем разности между центрами самого маленького и самого большого кластеров: $Q_x = 18{,}5126688 — 11{,}5299174 = 6{,}9827514$ и $Q_y = 21{,}1251054 — 8{,}8858558 = 12{,}2392496$. Умножаем на $10,000$ и берём целые части модулей: $69827$ и $122392$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала абсолютную величину целой части произведения $P_x \times 10,000$, затем абсолютную величину целой части произведения $P_y \times 10,000$; сначала абсолютную величину целой части произведения $Q_x \times 10,000$, затем абсолютную величину целой части произведения $Q_y \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании. Заметьте разницу с формулировкой для $P_x$ и $P_y$ — там среднее арифметическое действительно нужно, но уже от найденных центров.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог проверяем по результату: он должен дать ровно столько кластеров, сколько обещано в условии, и каждый должен укладываться в прямоугольник заданного размера.
Файл $А$. Всего $209$ точек (первая строка — заголовок $X$ $Y$). Разбиение устойчиво к выбору порога от $1$ до $2$: группы из $137$ и $72$ точек. Первая занимает область $x \in [6{,}13;\ 7{,}99]$, $y \in [18{,}49;\ 21{,}67]$, вторая — $x \in [3{,}15;\ 4{,}64]$, $y \in [5{,}72;\ 8{,}60]$. Обе укладываются в прямоугольник $6 \times 4{,}5$. Аномалий в файле $А$ нет, лишних одиночных точек алгоритм не находит.
Файл $Б$. Здесь $609$ точек. Разбиение снова устойчиво: группы размерами $397$, $137$, $72$ и три одиночные точки — это и есть обещанные аномалии. Проверка: у каждой из них ближайший сосед находится на расстоянии больше $24$, тогда как внутри кластеров точки идут вплотную. Кластер с минимальным количеством точек — тот, где их $72$, с максимальным — где $397$; складываются координаты именно их центров, средний кластер из $137$ точек в ответ не входит.
import openpyxl, math

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-06_A.xlsx')
cs = [center(c) for c in clusters(A) if len(c) > 3]
Px = sum(p[0] for p in cs) / len(cs)
Py = sum(p[1] for p in cs) / len(cs)
print(abs(int(Px * 10000)), abs(int(Py * 10000)))

B = load('27-06_B.xlsx')                  # одиночки отсеиваются как аномалии
cl = sorted((c for c in clusters(B) if len(c) > 3), key=len)
c_min, c_max = center(cl[0]), center(cl[-1])
Qx, Qy = c_min[0] + c_max[0], c_min[1] + c_max[1]
print(abs(int(Qx * 10000)), abs(int(Qy * 10000)))
Результаты для файла $А$. Центры кластеров: $(7{,}1031803;\ 19{,}817861)$ и $(3{,}9558582;\ 7{,}556738)$. Отсюда $P_x = (7{,}1031803 + 3{,}9558582) / 2 = 5{,}52951925$ и $P_y = (19{,}817861 + 7{,}556738) / 2 = 13{,}6872995$. После умножения на $10,000$ и отбрасывания дробной части получаем $55295$ и $136872$.
Результаты для файла $Б$. Центры кластеров: $(25{,}3459999;\ 22{,}8268984)$ для кластера из $72$ точек, $(18{,}3161517;\ 26{,}2694763)$ для кластера из $137$ точек и $(6{,}5724924;\ 22{,}0374135)$ для кластера из $397$ точек. Складываем координаты центров самого маленького и самого большого кластеров: $Q_x = 25{,}3459999 + 6{,}5724924 = 31{,}9184923$ и $Q_y = 22{,}8268984 + 22{,}0374135 = 44{,}8643119$, что даёт $319184$ и $448643$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала целую часть абсолютной величины произведения $A_x \times 10,000$, затем целую часть абсолютной величины произведения $A_y \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем целую часть произведения $B_2 \times 10,000$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам, иначе задачу не решить. Оранжевый субкарлик — это спектральный класс $K$ и класс светимости $VI$. Жёлто-белый яркий гигант — класс $F$ и светимость $II$. Белый яркий гигант — класс $A$ и светимость $II$. Классы светимости $V$, $VI$ и $VII$ легко перепутать: $K2V$ — это карлик, $K2VI$ — субкарлик, а $VII$ вообще записан без буквы спектрального класса.
Разбор строки. Первые два поля — координаты (с запятой в качестве десятичного разделителя). Третье поле либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — это первый символ, а класс светимости — всё начиная с третьего символа (второй символ — подкласс, он нигде не нужен). Белые карлики $VII$ обрабатываем отдельно: спектрального класса у них нет.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. Здесь порог нужно взять равным $1$: при большем значении два кластера файла $Б$ сливаются в один, и вместо трёх кластеров получаются два. Это важная проверка — количество найденных кластеров должно совпасть с указанным в условии.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
import math
from itertools import combinations

def load(name):
    P = []
    for line in open(name, encoding='utf-8-sig'):
        p = line.replace(',', '.').split()
        if len(p) < 3:
            continue
        s = p[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(p[0]), float(p[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-07_A.xls')
big = max(clusters(A), key=len)                 # самый многочисленный кластер
cn = center(big)
sub = [p for p in big if p[2] == 'K' and p[3] == 'VI']    # оранжевые субкарлики
best = min(sub, key=lambda p: math.dist(p[:2], cn[:2]))
print(int(abs(best[0] * 10000)), int(abs(best[1] * 10000)))

B = load('27-07_B.xls')
cl = sorted(clusters(B), key=lambda c: sum(p[2] == 'F' and p[3] == 'II' for p in c))
B1 = math.dist(center(cl[0])[:2], center(cl[-1])[:2])
B2 = max(math.dist(u[:2], v[:2])
         for c in cl
         for u, v in combinations([p for p in c if p[2] == 'A' and p[3] == 'II'], 2))
print(int(B1 * 10000), int(B2 * 10000))
Результаты для файла $А$. Всего $406$ звёзд, кластеры содержат $189$ и $217$ точек. Больший занимает область $x \in [5{,}14;\ 9{,}74]$, $y \in [18{,}15;\ 21{,}69]$ и укладывается в прямоугольник $6{,}0 \times 5{,}5$. Его центр — звезда $(7{,}637742;\ 19{,}984805)$ класса $M4V$. Оранжевых субкарликов ($K$, $VI$) в этом кластере три; ближайший к центру — звезда $K7VI$ с координатами $(7{,}69655;\ 20{,}155777)$, она удалена от центра на $0{,}1808$. Отсюда $A_x = 7{,}69655$ и $A_y = 20{,}155777$, а после умножения на $10,000$ и отбрасывания дробной части — $76965$ и $201557$.
Результаты для файла $Б$. Всего $1851$ звезда, кластеры содержат $1170$, $393$ и $288$ точек, их центры — $(11{,}783578;\ 25{,}014369)$, $(13{,}255911;\ 36{,}603664)$ и $(18{,}785875;\ 36{,}884352)$. Жёлто-белых ярких гигантов ($F$, $II$) в них $27$, $8$ и $7$ соответственно, то есть меньше всего — в кластере из $288$ точек, больше всего — в кластере из $1170$ точек. Расстояние между их центрами $B_1 = 13{,}7814607$.
Белые яркие гиганты ($A$, $II$) есть во всех трёх кластерах ($21$, $6$ и $6$ штук). Перебирая пары внутри каждого кластера, получаем наибольшее расстояние $B_2 = 3{,}0732468$. Умножаем на $10,000$ и берём целые части: $137814$ и $30732$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала целую часть абсолютной величины произведения $A_x \times 10,000$, затем целую часть абсолютной величины произведения $A_y \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем целую часть произведения $B_2 \times 10,000$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам. Красный гигант — спектральный класс $M$ и светимость $III$. Оранжевый гигант — класс $K$ и светимость $III$. Жёлтый карлик — класс $G$ и светимость $V$. Классы $V$, $VI$ и $VII$ легко перепутать: $G2V$ — карлик, $G2VI$ — субкарлик, а $VII$ записан вообще без буквы.
Разбор строки. Первые два поля — координаты, третье либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — первый символ, класс светимости — всё начиная с третьего (второй символ — подкласс, он нигде не нужен). Белые карлики обрабатываем отдельно: спектрального класса у них нет.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве, и достаточно разбить точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. Здесь порог нужно выбирать аккуратно — годится значение около $1{,}0$–$1{,}5$. При пороге $0{,}8$ от кластера в файле $А$ отрывается одиночная точка, а при пороге $2$ два кластера файла $Б$ сливаются в один. Проверка простая: количество найденных кластеров должно совпасть с указанным в условии, а каждый кластер — уместиться в прямоугольник $6{,}0 \times 5{,}5$.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
import math
from itertools import combinations

def load(name):
    P = []
    for line in open(name):
        p = line.strip().strip('"').replace(',', '.').split()
        if len(p) < 3:
            continue
        s = p[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(p[0]), float(p[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-09_A1.csv')
small = min(clusters(A), key=len)                 # наименьший кластер
cn = center(small)
red = [p for p in small if p[2] == 'M' and p[3] == 'III']    # красные гиганты
best = min(red, key=lambda p: math.dist(p[:2], cn[:2]))
print(int(abs(best[0] * 10000)), int(abs(best[1] * 10000)))

B = load('27-09_B1.csv')
cl = sorted(clusters(B, 1.0),
            key=lambda c: sum(p[2] == 'K' and p[3] == 'III' for p in c))
B1 = math.dist(center(cl[0])[:2], center(cl[-1])[:2])
B2 = max(math.dist(u[:2], v[:2])
         for c in cl
         for u, v in combinations([p for p in c if p[2] == 'G' and p[3] == 'V'], 2))
print(int(B1 * 10000), int(B2 * 10000))
Результаты для файла $А$. Всего $234$ звезды, кластеры содержат $114$ и $121$ точку. Наименьший — из $114$ звёзд, он занимает область $x \in [3{,}12;\ 7{,}37]$, $y \in [5{,}58;\ 8{,}92]$ и укладывается в прямоугольник $6{,}0 \times 5{,}5$. Его центр — звезда $O0I$ с координатами $(4{,}960398;\ 7{,}34545)$. Красных гигантов ($M$, $III$) в этом кластере три; ближайший к центру удалён на $0{,}6148$ и имеет координаты $(4{,}469472;\ 6{,}975433)$. Отсюда $A_x = 4{,}469472$ и $A_y = 6{,}975433$, что после умножения на $10,000$ и отбрасывания дробной части даёт $44694$ и $69754$.
Результаты для файла $Б$. Всего $1851$ звезда, кластеры содержат $1170$, $393$ и $288$ точек с центрами $(11{,}746691;\ 24{,}957689)$, $(13{,}223572;\ 36{,}619979)$ и $(18{,}794456;\ 36{,}905542)$. Оранжевых гигантов ($K$, $III$) в них $87$, $28$ и $25$: меньше всего в кластере из $288$ точек, больше всего в кластере из $1170$ точек. Расстояние между их центрами $B_1 = 13{,}8716323$.
Жёлтых карликов ($G$, $V$) в кластерах $20$, $8$ и $6$; перебирая пары внутри каждого кластера, получаем наибольшее расстояние $B_2 = 3{,}4029521$. Умножаем на $10,000$ и берём целые части: $138716$ и $34029$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала $A_1$, затем целую часть произведения $A_2 \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем $B_2$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам. Красный гигант — спектральный класс $M$ и светимость $III$. Голубой гигант — класс $O$ и светимость $III$. Жёлтый карлик — класс $G$ и светимость $V$. Классы $V$, $VI$ и $VII$ легко перепутать: $G2V$ — карлик, $G2VI$ — субкарлик, а $VII$ записан вообще без буквы.
Разбор строки. Первые два поля — координаты, третье либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — первый символ, класс светимости — всё начиная с третьего (второй символ — подкласс, он нигде не нужен). Белые карлики обрабатываем отдельно: спектрального класса у них нет.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве, и достаточно разбить точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. В файле $А$ при пороге $0{,}8$ от кластеров отрываются две одиночные точки, поэтому берём порог $1{,}5$ — тогда получаются ровно два кластера, каждый из которых укладывается в прямоугольник $6{,}0 \times 5{,}5$. В файле $Б$ результат устойчив при любом пороге от $0{,}8$ до $2$.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
import math

def load(name):
    P = []
    for line in open(name):
        p = line.strip().split(',')      # csv, полученный из xls
        if len(p) < 3 or not p[0]:
            continue
        s = p[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(p[0]), float(p[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-08_A.csv')
ca = clusters(A)
cn = center(min(ca, key=len))                    # центр наименьшего кластера
A1 = sum(p[2] == 'M' and p[3] == 'III' and math.dist(p[:2], cn[:2]) <= 1.0
         for p in min(ca, key=len))
A2 = math.dist(center(ca[0])[:2], center(ca[1])[:2])
print(A1, int(A2 * 10000))

B = load('27-08_B.csv')
B1, B2 = None, 0
for c in clusters(B):
    cc = center(c)
    for p in c:
        if p[2] == 'O' and p[3] == 'III':
            d = math.dist(p[:2], cc[:2])
            B1 = d if B1 is None else min(B1, d)
    B2 = max(B2, sum(p[2] == 'G' and p[3] == 'V' for p in c))
print(int(B1 * 10000), B2)
Результаты для файла $А$. Всего $457$ звёзд, кластеры содержат $219$ и $238$ точек. Наименьший — из $219$ звёзд, он занимает область $x \in [2{,}76;\ 7{,}46]$, $y \in [5{,}37;\ 9{,}24]$, его центр — белый карлик с координатами $(4{,}965068;\ 7{,}35106)$. Красных гигантов ($M$, $III$) в этом кластере пять, их удаления от центра равны $0{,}6209$, $0{,}7462$, $0{,}8093$, $1{,}2616$ и $1{,}5250$. В пределы $1{,}0$ попадают три, значит, $A_1 = 3$.
Центр второго кластера — $(7{,}82126;\ 19{,}951507)$, расстояние между центрами $A_2 = 12{,}9201044$, что после умножения на $10,000$ и отбрасывания дробной части даёт $129201$.
Результаты для файла $Б$. Всего $1230$ звёзд, кластеры содержат $887$, $199$ и $144$ точки с центрами $(26{,}192945;\ 17{,}908655)$, $(16{,}390477;\ 19{,}314145)$ и $(14{,}5862;\ 26{,}920069)$. Голубых гигантов ($O$, $III$) во всём файле всего шесть, и все они лежат в первом кластере; ближайший к его центру удалён на $B_1 = 0{,}460128$, что даёт $4601$.
Жёлтых карликов ($G$, $V$) в кластерах $13$, $6$ и $6$ штук, поэтому $B_2 = 13$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала целую часть абсолютной величины произведения $A_x \times 10,000$, затем целую часть абсолютной величины произведения $A_y \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем целую часть произведения $B_2 \times 10,000$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам. Бело-голубой яркий гигант — спектральный класс $B$ и светимость $II$. Жёлтый карлик — класс $G$ и светимость $V$. Оранжевый карлик — класс $K$ и светимость $V$. Классы $V$, $VI$ и $VII$ легко перепутать: $K2V$ — карлик, $K2VI$ — субкарлик, а $VII$ записан вообще без буквы.
Разбор строки. Первые два поля — координаты, третье либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — первый символ, класс светимости — всё начиная с третьего (второй символ — подкласс, он нигде не нужен). Белые карлики обрабатываем отдельно: спектрального класса у них нет.
Отдельная сложность этих файлов — разнобой в десятичных разделителях: часть чисел записана с точкой и распознана таблицей как число, часть с запятой и осталась текстом, из-за чего некоторые строки склеены в одну ячейку. Поэтому надёжнее собрать текст всей строки, заменить запятые на точки и разделить по пробелам — тогда в любом случае получаются три поля. Именно так работает функция load ниже, читающая .ods напрямую.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве, и достаточно разбить точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. Здесь подходит порог $1{,}0$: при пороге $1{,}5$ два кластера файла $Б$ сливаются в один и вместо трёх получаются два. Проверка простая: количество найденных кластеров должно совпасть с указанным в условии, а каждый кластер — уместиться в прямоугольник $6{,}0 \times 5{,}5$.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
import zipfile, math
from xml.etree import ElementTree as ET
from itertools import combinations

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()   # чиним разнобой форматов
        if len(tok) < 3: continue
        s = tok[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(tok[0]), float(tok[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-10_A.ods')
big = max(clusters(A), key=len)                  # самый многочисленный кластер
cn = center(big)
bb = [p for p in big if p[2] == 'B' and p[3] == 'II']
best = min(bb, key=lambda p: math.dist(p[:2], cn[:2]))
print(int(abs(best[0] * 10000)), int(abs(best[1] * 10000)))

B = load('27-10_B.ods')
cl = sorted(clusters(B), key=lambda c: sum(p[2] == 'G' and p[3] == 'V' for p in c))
B1 = math.dist(center(cl[0])[:2], center(cl[-1])[:2])
B2 = max(math.dist(u[:2], v[:2])
         for c in cl
         for u, v in combinations([p for p in c if p[2] == 'K' and p[3] == 'V'], 2))
print(int(B1 * 10000), int(B2 * 10000))
Результаты для файла $А$. Всего $406$ звёзд, кластеры содержат $189$ и $217$ точек. Больший занимает область $x \in [5{,}17;\ 9{,}72]$, $y \in [18{,}00;\ 21{,}78]$ и укладывается в прямоугольник $6{,}0 \times 5{,}5$. Его центр — звезда $K3III$ с координатами $(7{,}809724;\ 19{,}825386)$. Бело-голубых ярких гигантов ($B$, $II$) в этом кластере три; ближайший к центру удалён на $0{,}6126$ и имеет координаты $(8{,}405798;\ 19{,}684129)$. Отсюда $A_x = 8{,}405798$ и $A_y = 19{,}684129$, что после умножения на $10,000$ и отбрасывания дробной части даёт $84057$ и $196841$.
Результаты для файла $Б$. Всего $1851$ звезда, кластеры содержат $1170$, $393$ и $288$ точек с центрами $(11{,}734736;\ 24{,}990912)$, $(13{,}218446;\ 36{,}584488)$ и $(18{,}7851;\ 36{,}95248)$. Жёлтых карликов ($G$, $V$) в них $25$, $8$ и $11$: меньше всего в кластере из $393$ точек, больше всего в кластере из $1170$ точек. Расстояние между их центрами $B_1 = 11{,}6881307$.
Оранжевых карликов ($K$, $V$) в кластерах $24$, $10$ и $2$; перебирая пары внутри каждого кластера, получаем наибольшее расстояние $B_2 = 3{,}891464$. Умножаем на $10,000$ и берём целые части: $116881$ и $38914$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала $A_1$, затем целую часть произведения $A_2 \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем $B_2$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам. Жёлтый субгигант — спектральный класс $G$ и светимость $IV$. Оранжевый гигант — класс $K$ и светимость $III$. Белый яркий гигант — класс $A$ и светимость $II$. Классы $V$, $VI$ и $VII$ легко перепутать: $G2V$ — карлик, $G2VI$ — субкарлик, а $VII$ записан вообще без буквы.
Разбор строки. Первые два поля — координаты, третье либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — первый символ, класс светимости — всё начиная с третьего (второй символ — подкласс, он нигде не нужен). Белые карлики обрабатываем отдельно: спектрального класса у них нет.
Ещё одна тонкость этих файлов — разнобой в десятичных разделителях: часть чисел записана с точкой и распознана таблицей как число, часть с запятой и осталась текстом. Поэтому надёжнее собрать текст всей строки, заменить запятые на точки и разделить по пробелам — тогда в любом случае получаются три поля.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве, и достаточно разбить точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. Здесь результат устойчив при любом пороге от $0{,}8$ до $2$, что само по себе хороший признак. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник $6{,}0 \times 5{,}5$.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
Обратите внимание на разную логику двух величин: в $A_1$ и $B_1$ речь идёт об удалении от центра своего кластера, но в первом случае считается количество звёзд в круге радиуса $1{,}2$, а во втором — наибольшее удаление, причём максимум берётся по всем кластерам сразу.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()   # чиним разнобой форматов
        if len(tok) < 3: continue
        s = tok[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(tok[0]), float(tok[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-11_A.ods')
ca = clusters(A)
small = min(ca, key=len)                       # наименьший кластер
cn = center(small)
A1 = sum(p[2] == 'G' and p[3] == 'IV' and math.dist(p[:2], cn[:2]) <= 1.2
         for p in small)
A2 = math.dist(center(ca[0])[:2], center(ca[1])[:2])
print(A1, int(A2 * 10000))

B = load('27-11_B.ods')
B1 = B2 = 0
for c in clusters(B):
    cc = center(c)
    for p in c:
        if p[2] == 'K' and p[3] == 'III':
            B1 = max(B1, math.dist(p[:2], cc[:2]))
    B2 = max(B2, sum(p[2] == 'A' and p[3] == 'II' for p in c))
print(int(B1 * 10000), B2)
Результаты для файла $А$. Всего $457$ звёзд, кластеры содержат $219$ и $238$ точек. Наименьший — из $219$ звёзд, он занимает область $x \in [2{,}94;\ 7{,}41]$, $y \in [5{,}43;\ 9{,}21]$, его центр — звезда $M3III$ с координатами $(5{,}025911;\ 7{,}299077)$. Жёлтых субгигантов ($G$, $IV$) в этом кластере $21$, в круг радиуса $1{,}2$ вокруг центра попадают $14$ из них, значит, $A_1 = 14$.
Центр второго кластера — $(7{,}878035;\ 19{,}907808)$, расстояние между центрами $A_2 = 12{,}9272854$, что даёт $129272$.
Результаты для файла $Б$. Всего $1230$ звёзд, кластеры содержат $887$, $199$ и $144$ точки с центрами $(26{,}240133;\ 17{,}935236)$, $(16{,}355297;\ 19{,}37937)$ и $(14{,}592412;\ 26{,}897683)$. Оранжевых гигантов ($K$, $III$) в них $59$, $20$ и $14$; наибольшее удаление такой звезды от центра своего кластера по кластерам равно $2{,}2690$, $1{,}9855$ и $1{,}6737$, значит, $B_1 = 2{,}268970$ и в ответ идёт $22689$.
Белых ярких гигантов ($A$, $II$) в кластерах $21$, $3$ и $1$, поэтому $B_2 = 21$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку (звезду) этого кластера, сумма расстояний от которой до всех остальных его точек минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости $A(x_1, y_1)$ и $B(x_2, y_2)$ вычисляется по формуле $d(A, B) = \sqrt{(x_2 — x_1)^2 + (y_2 — y_1)^2}$.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) следующим образом.
| Обозначение спектрального класса (латинская буква) | $O$ | $B$ | $A$ | $F$ | $G$ | $K$ | $M$ |
|---|---|---|---|---|---|---|---|
| Цвет звезды | Голубой | Бело-голубой | Белый | Жёлто-белый | Жёлтый | Оранжевый | Красный |
Каждый из спектральных классов, в свою очередь, делится на подклассы от $0$ до $9$ в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, $B2$). Класс светимости звезды обозначим римскими цифрами от $I$ до $VII$.
| Обозначение класса светимости | $I$ | $II$ | $III$ | $IV$ | $V$ | $VI$ | $VII$ |
|---|---|---|---|---|---|---|---|
| Светимость | Сверхгигант | Яркий гигант | Гигант | Субгигант | Карлик | Субкарлик | Белый карлик |
В ответе запишите четыре числа через запятую: сначала $A_1$, затем целую часть произведения $A_2 \times 10,000$; сначала целую часть произведения $B_1 \times 10,000$, затем $B_2$.
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788     8,32466      G2V
4,289251    6,955186     VII
4,619358    5,524697     B7V
6,91934     20,425391    G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Сначала расшифруем обозначения по двум таблицам. Бело-голубой яркий гигант — спектральный класс $B$ и светимость $II$. Жёлтый карлик — класс $G$ и светимость $V$. Оранжевый карлик — класс $K$ и светимость $V$. Классы $V$, $VI$ и $VII$ легко перепутать: $K2V$ — карлик, $K2VI$ — субкарлик, а $VII$ записан вообще без буквы.
Разбор строки. Первые два поля — координаты, третье либо равно $VII$, либо устроено как «буква, цифра, римское число». Значит, спектральный класс — первый символ, класс светимости — всё начиная с третьего (второй символ — подкласс, он нигде не нужен). Белые карлики обрабатываем отдельно: спектрального класса у них нет.
Ещё одна тонкость этих файлов — разнобой в десятичных разделителях: часть чисел записана с точкой и распознана таблицей как число, часть с запятой и осталась текстом. Поэтому надёжнее собрать текст всей строки, заменить запятые на точки и разделить по пробелам — тогда в любом случае получаются три поля.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве, и достаточно разбить точки на компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на порог. Порог $0{,}8$ здесь мал — от кластеров файла $А$ отрываются две одиночные точки; начиная с $1{,}0$ результат устойчив. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник $6{,}0 \times 5{,}5$.
Центр кластера — точка самого кластера с минимальной суммой расстояний до остальных, ищем перебором. Считать среднее арифметическое координат нельзя.
Обратите внимание на разную логику: в $A_1$ считается количество звёзд в круге радиуса $1{,}5$ вокруг центра одного конкретного кластера, а в $B_1$ — наибольшее удаление звезды от центра своего кластера, причём максимум берётся по всем трём кластерам сразу.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()   # чиним разнобой форматов
        if len(tok) < 3: continue
        s = tok[2]
        sp, lum = (None, 'VII') if s == 'VII' else (s[0], s[2:])
        P.append((float(tok[0]), float(tok[1]), sp, lum))
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a[:2], b[:2]) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a][:2], pts[j][:2]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-12_A.ods')
ca = clusters(A)
small = min(ca, key=len)                       # наименьший кластер
cn = center(small)
A1 = sum(p[2] == 'B' and p[3] == 'II' and math.dist(p[:2], cn[:2]) <= 1.5
         for p in small)
A2 = math.dist(center(ca[0])[:2], center(ca[1])[:2])
print(A1, int(A2 * 10000))

B = load('27-12_B.ods')
B1 = B2 = 0
for c in clusters(B):
    cc = center(c)
    for p in c:
        if p[2] == 'G' and p[3] == 'V':
            B1 = max(B1, math.dist(p[:2], cc[:2]))
    B2 = max(B2, sum(p[2] == 'K' and p[3] == 'V' for p in c))
print(int(B1 * 10000), B2)
Результаты для файла $А$. Всего $457$ звёзд, кластеры содержат $219$ и $238$ точек. Наименьший — из $219$ звёзд, он занимает область $x \in [2{,}78;\ 7{,}56]$, $y \in [5{,}45;\ 9{,}11]$, его центр — звезда $M3III$ с координатами $(4{,}832603;\ 7{,}393669)$. Бело-голубых ярких гигантов ($B$, $II$) в этом кластере восемь, их удаления от центра равны $0{,}4742$, $0{,}5051$, $0{,}6113$, $0{,}7959$, $0{,}9693$, $1{,}2403$, $1{,}4553$ и $2{,}4023$. В пределы $1{,}5$ попадают семь, значит, $A_1 = 7$.
Центр второго кластера — $(7{,}768393;\ 19{,}887058)$, расстояние между центрами $A_2 = 12{,}8336913$, что даёт $128336$.
Результаты для файла $Б$. Всего $1230$ звёзд, кластеры содержат $887$, $199$ и $144$ точки с центрами $(26{,}213319;\ 17{,}910683)$, $(16{,}357226;\ 19{,}319376)$ и $(14{,}591678;\ 26{,}825594)$. Жёлтых карликов ($G$, $V$) в них $16$, $3$ и $3$; наибольшее удаление такой звезды от центра своего кластера по кластерам равно $1{,}8339$, $1{,}6153$ и $1{,}2868$, значит, $B_1 = 1{,}8339003$ и в ответ идёт $18339$.
Оранжевых карликов ($K$, $V$) в кластерах $13$, $6$ и $3$, поэтому $B_2 = 13$.
20
В лаборатории проводится эксперимент, состоящий из множества испытаний. Результат каждого испытания представляется в виде пары чисел. Для визуализации результатов эта пара рассматривается как координаты точки на плоскости, и на чертеже отмечаются точки, соответствующие всем испытаниям.
По результатам эксперимента проводится кластеризация полученных результатов: на плоскости выделяется несколько кластеров — кругов радиуса не более $3$ единиц так, что каждая точка попадает ровно в один кластер.
Вам даны два входных файла ($А$ и $B$), каждый из которых имеет описанную выше структуру. По данным каждого из представленных файлов определите средний радиус по описанным выше правилам.
В ответе запишите два числа: сначала средний радиус для файла $А$, затем для файла $B$. В качестве значения указывайте целую часть от умножения найденного числового значения на $10000$.
Определение центра здесь не такое, как в «звёздных» задачах: минимизируется не сумма расстояний, а максимальное расстояние до остальных точек кластера. Это чебышёвский центр, выбранный среди самих точек, и вместе с ним автоматически получается радиус — то самое минимальное максимальное расстояние. Считается всё одним двойным перебором: для каждой точки кластера находим её удаление от самой далёкой точки кластера, затем берём точку с наименьшим таким значением.
Кластеризация. Кластеры — плотные сгустки точек, разделённые пустыми промежутками, поэтому разбиваем точки на компоненты связности с небольшим порогом. Дальше обязательно проверяем результат: все найденные кластеры должны укладываться в круг радиуса не более $3$.
С порогом здесь надо быть аккуратным в обе стороны. В файле $А$ порог $0{,}5$ мал — от кластеров отрывается одиночная точка; начиная с $1{,}0$ получаются три устойчивые группы. В файле $B$ наоборот: уже при пороге $1{,}0$ две соседние группы сливаются, поэтому берём $0{,}5$ и получаем пять групп. Что групп действительно пять, видно по зазорам: минимальное расстояние между точками разных кластеров равно $0{,}84$ у самой близкой пары групп и заметно больше у остальных, тогда как внутри каждой группы точки идут вплотную.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass          # строка заголовка
    return P

def clusters(pts, eps):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

def radius(c):                            # центр — минимакс, радиус — его максимум
    return min(max(math.dist(a, b) for b in c) for a in c)

for name, eps in [('27-14-A.ods', 1.0), ('27-14-B.ods', 0.5)]:
    cl = sorted(clusters(load(name), eps), key=len)
    r = [radius(c) for c in cl[1:]]       # самый малочисленный кластер исключаем
    print(int(sum(r) / len(r) * 10000))
Результаты для файла $А$. Всего $942$ точки, три кластера по $309$, $314$ и $319$ точек с центрами $(-0{,}8791;\ 0{,}9956)$, $(1{,}6313;\ 4{,}1401)$ и $(5{,}0790;\ 7{,}0557)$ и радиусами $0{,}847718$, $0{,}832726$ и $1{,}167601$. Все радиусы меньше $3$ — разбиение допустимо. Исключаем самый малочисленный кластер (из $309$ точек, радиус $0{,}847718$) и усредняем оставшиеся: $(0{,}832726 + 1{,}167601) / 2 = 1{,}0001633$, что после умножения на $10,000$ даёт $10001$.
Результаты для файла $B$. Всего $9917$ точек, пять кластеров: $1907$, $1940$, $2011$, $2027$ и $2032$ точки. Их центры — $(0{,}9903;\ 7{,}1282)$, $(-2{,}9906;\ 0{,}9137)$, $(4{,}9732;\ 7{,}0110)$, $(3{,}0064;\ 3{,}9177)$ и $(0{,}8339;\ 3{,}0211)$, радиусы — $1{,}611410$, $1{,}010885$, $0{,}507085$, $1{,}071062$ и $0{,}812671$, все укладываются в $3$. Исключаем кластер из $1907$ точек и усредняем четыре оставшихся радиуса: $(1{,}010885 + 0{,}507085 + 1{,}071062 + 0{,}812671) / 4 = 0{,}8504258$, что даёт $8504$.
20
В лаборатории проводится эксперимент, состоящий из множества испытаний. Результат каждого испытания представляется в виде пары чисел. Для визуализации результатов эта пара рассматривается как координаты точки на плоскости, и на чертеже отмечаются точки, соответствующие всем испытаниям.
По результатам эксперимента проводится кластеризация полученных результатов: на плоскости выделяется несколько кластеров — кругов радиуса не более $3$ единиц так, что каждая точка попадает ровно в один кластер.
Вам даны два входных файла ($А$ и $B$), каждый из которых имеет описанную выше структуру. По данным каждого из представленных файлов определите средний радиус по описанным выше правилам.
В ответе запишите два числа через запятую: сначала средний радиус для файла $А$, затем для файла $B$. В качестве значения указывайте целую часть от умножения найденного числового значения на $10000$.
Определение центра здесь не такое, как в «звёздных» задачах: минимизируется не сумма расстояний, а максимальное расстояние до остальных точек кластера. Это чебышёвский центр, выбранный среди самих точек, и вместе с ним сразу получается радиус — то самое минимальное максимальное расстояние. Считается всё одним двойным перебором: для каждой точки кластера находим её удаление от самой далёкой точки кластера, затем берём наименьшее из этих значений.
Кластеризация. Кластеры — плотные сгустки точек, разделённые пустыми промежутками, поэтому разбиваем точки на компоненты связности с небольшим порогом. Дальше обязательно проверяем результат: все найденные кластеры должны укладываться в круг радиуса не более $3$.
С порогом надо быть аккуратным в обе стороны. В файле $А$ порог $0{,}5$ мал — от кластеров отрывается одиночная точка; начиная с $1{,}0$ получаются три устойчивые группы. В файле $B$ наоборот: уже при пороге $1{,}0$ две соседние группы сливаются, поэтому берём $0{,}5$ и получаем пять групп. Что групп действительно пять, видно по зазорам: у самой близкой пары групп минимальное расстояние между точками разных кластеров равно $0{,}84$, у остальных больше, тогда как внутри каждой группы точки идут вплотную.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def clusters(pts, eps):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

def radius(c):                            # центр — минимакс, радиус — его максимум
    return min(max(math.dist(a, b) for b in c) for a in c)

for name, eps in [('27-15-A.ods', 1.0), ('27-15-B.ods', 0.5)]:
    cl = sorted(clusters(load(name), eps), key=len)
    r = [radius(c) for c in cl[:-1]]      # самый многочисленный кластер исключаем
    print(int(sum(r) / len(r) * 10000))
Результаты для файла $А$. Всего $942$ точки, три кластера по $309$, $314$ и $319$ точек с радиусами $0{,}847718$, $0{,}832726$ и $1{,}167601$. Все радиусы меньше $3$ — разбиение допустимо. Исключаем самый многочисленный кластер (из $319$ точек, радиус $1{,}167601$) и усредняем оставшиеся: $(0{,}847718 + 0{,}832726) / 2 = 0{,}8402222$, что после умножения на $10,000$ даёт $8402$.
Результаты для файла $B$. Всего $9917$ точек, пять кластеров: $1907$, $1940$, $2011$, $2027$ и $2032$ точки с радиусами $1{,}611410$, $1{,}010885$, $0{,}507085$, $1{,}071062$ и $0{,}812671$; все укладываются в $3$. Исключаем кластер из $2032$ точек (радиус $0{,}812671$) и усредняем четыре оставшихся: $(1{,}611410 + 1{,}010885 + 0{,}507085 + 1{,}071062) / 4 = 1{,}0501104$, что даёт $10501$.
Обратите внимание, насколько разными получаются ответы при исключении наибольшего и наименьшего кластера: в файле $B$ размеры кластеров близки ($1907$ против $2032$), и перепутать их легко, а результат меняется с $8504$ на $10501$.
20
В лаборатории проводится эксперимент, состоящий из множества испытаний. Результат каждого испытания представляется в виде пары чисел. Для визуализации результатов эта пара рассматривается как координаты точки на плоскости, и на чертеже отмечаются точки, соответствующие всем испытаниям.
По результатам эксперимента проводится кластеризация полученных результатов: на плоскости выделяется несколько кластеров — кругов радиуса не более $3$ единиц так, что каждая точка попадает ровно в один кластер.
Вам даны два входных файла ($А$ и $B$), каждый из которых имеет описанную выше структуру. По данным каждого из представленных файлов определите средний радиус по описанным выше правилам.
В ответе запишите два числа через запятую: сначала средний радиус для файла $А$, затем для файла $B$. В качестве значения указывайте целую часть от умножения найденного числового значения на $10000$.
Определение центра здесь не такое, как в «звёздных» задачах: минимизируется не сумма расстояний, а максимальное расстояние до остальных точек кластера. Это чебышёвский центр, выбранный среди самих точек, и вместе с ним сразу получается радиус — то самое минимальное максимальное расстояние. Считается всё одним двойным перебором: для каждой точки кластера находим её удаление от самой далёкой точки кластера, затем берём наименьшее из этих значений.
Кластеризация. Кластеры — плотные сгустки точек, разделённые пустыми промежутками, поэтому разбиваем точки на компоненты связности с небольшим порогом. Дальше обязательно проверяем результат: все найденные кластеры должны укладываться в круг радиуса не более $3$.
Порог здесь критичен в обе стороны. При $0{,}3$ от кластеров отрываются одиночные точки — в файле $А$ таких обрывков четыре, в файле $B$ три. При $1{,}0$ и больше в файле $B$ две соседние группы сливаются, и вместо пяти кластеров остаётся четыре. Устойчивый диапазон — от $0{,}5$ до $0{,}8$, его и берём. Что групп в файле $B$ действительно пять, подтверждают зазоры: у самой близкой пары групп минимальное расстояние между точками разных кластеров равно $0{,}84$, у остальных пар — от $1{,}56$ и больше, тогда как внутри каждой группы точки идут вплотную.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def clusters(pts, eps=0.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

def radius(c):                            # центр — минимакс, радиус — его максимум
    return min(max(math.dist(a, b) for b in c) for a in c)

for name in ['27-13_A.ods', '27-13_B.ods']:
    cl = sorted(clusters(load(name)), key=len)
    r = [radius(c) for c in cl[:-1]]      # самый многочисленный кластер исключаем
    print(int(sum(r) / len(r) * 10000))
Результаты для файла $А$. Всего $880$ точек, три кластера по $285$, $291$ и $304$ точки с центрами $(1{,}9020;\ 3{,}9863)$, $(-1{,}0156;\ 1{,}0238)$ и $(4{,}9314;\ 6{,}9158)$ и радиусами $0{,}783859$, $0{,}977617$ и $1{,}019754$. Все радиусы меньше $3$ — разбиение допустимо. Исключаем самый многочисленный кластер (из $304$ точек, радиус $1{,}019754$) и усредняем оставшиеся: $(0{,}783859 + 0{,}977617) / 2 = 0{,}8807380$, что после умножения на $10,000$ даёт $8807$.
Результаты для файла $B$. Всего $9927$ точек, пять кластеров: $1937$, $1972$, $1987$, $2011$ и $2020$ точек. Их центры — $(0{,}9597;\ 7{,}0404)$, $(5{,}0743;\ 7{,}0380)$, $(3{,}0335;\ 3{,}9589)$, $(-3{,}0818;\ 0{,}9859)$ и $(0{,}7991;\ 3{,}0539)$, радиусы — $1{,}450878$, $0{,}692539$, $1{,}011702$, $1{,}141591$ и $0{,}901021$, все укладываются в $3$. Исключаем кластер из $2020$ точек (радиус $0{,}901021$) и усредняем четыре оставшихся: $(1{,}450878 + 0{,}692539 + 1{,}011702 + 1{,}141591) / 4 = 1{,}0741776$, что даёт $10741$.
Обратите внимание, насколько близки размеры кластеров в файле $B$: от $1937$ до $2020$ точек. Ошибка в разбиении на единицы точек здесь может изменить то, какой кластер считается наибольшим, и испортить ответ — поэтому и важно, что при порогах от $0{,}5$ до $0{,}8$ результат не меняется.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала $P_1$, затем $P_2$; сначала целую часть произведения $Q_1 \times 10,000$, затем целую часть произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов иллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
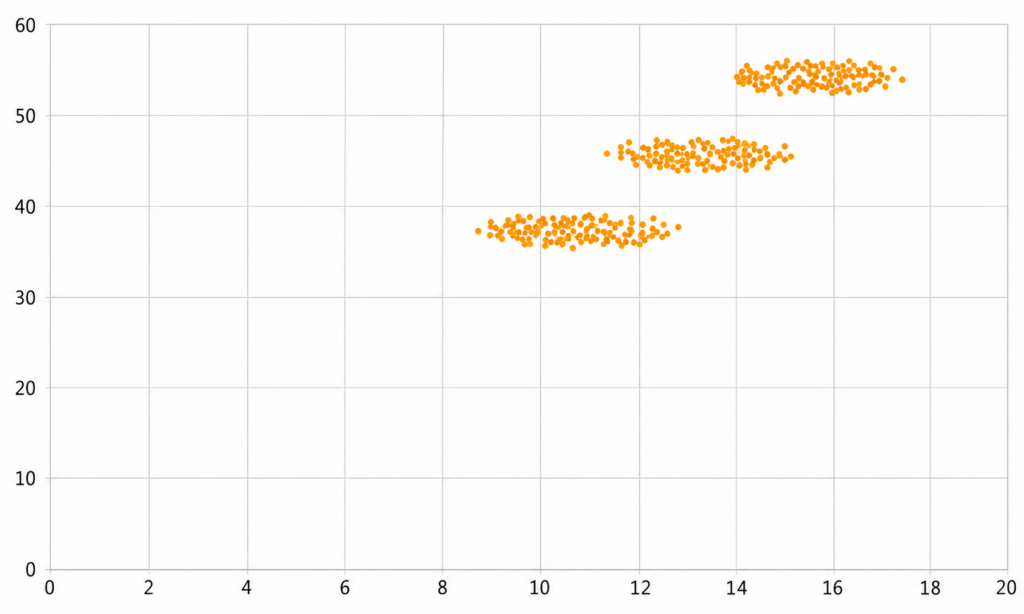
Центр здесь определяется через сумму расстояний (а не через минимакс, как в «лабораторных» задачах) — это точка самого кластера, ищем её перебором.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности, но порог здесь нужен заметно больше обычного: точек мало ($207$ и $473$), сгустки разрежены, и при пороге $0{,}8$ файл $А$ рассыпается на четыре куска. Устойчивый результат в файле $А$ начинается с $1{,}5$, в файле $Б$ он один и тот же при любом пороге от $0{,}5$ до $2$. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник заданного размера — например, больший кластер файла $А$ занимает $5{,}87$ по $x$ и $4{,}04$ по $y$ при допустимых $7$ и $5$.
Отдельно про формулировку $P_1$ и $P_2$: в ней сказано «точек на плоскости», а не «точек кластера», то есть считать надо все точки файла, а не только точки того кластера, чей центр взят. Для $P_1$ это ничего не меняет (в круге радиуса $0{,}9$ лежат только свои), а для $P_2$ разница существенная: далёкий второй кластер целиком попадает в «не менее $1{,}6$».
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-16_A.ods')
ca = clusters(A, 1.5)
cb, cs = center(max(ca, key=len)), center(min(ca, key=len))
P1 = sum(math.dist(p, cb) <= 0.9 for p in A)
P2 = sum(math.dist(p, cs) >= 1.6 for p in A)
print(P1, P2)

B = load('27-16_B.ods')
q = (2.8, 0.1)
d = [math.dist(center(c), q) for c in clusters(B, 1.0)]
print(int(min(d) * 10000), int(max(d) * 10000))
Результаты для файла $А$. Всего $207$ точек, кластеры содержат $112$ и $95$ точек. Больший занимает область $x \in [69{,}30;\ 75{,}17]$, $y \in [23{,}13;\ 27{,}17]$, его центр — $(72{,}650608;\ 25{,}162900)$; меньший занимает $x \in [82{,}42;\ 88{,}14]$, $y \in [52{,}98;\ 57{,}03]$ с центром $(85{,}288101;\ 55{,}033462)$.
В круг радиуса $0{,}9$ вокруг центра большего кластера попадают $12$ точек вместе с самим центром, значит, $P_1 = 12$.
На расстоянии не менее $1{,}6$ от центра меньшего кластера лежат $169$ точек: $57$ из самого этого кластера и все $112$ точек соседнего, который целиком удалён более чем на $30$ единиц. Отсюда $P_2 = 169$. Если понимать формулировку иначе — считать только точки того же кластера, — получилось бы $57$; на мой взгляд, слова «точек на плоскости» указывают именно на все точки файла.
Результаты для файла $Б$. Всего $473$ точки, три кластера по $166$, $157$ и $150$ точек с центрами $(14{,}775198;\ 37{,}051204)$, $(13{,}883750;\ 30{,}908588)$ и $(15{,}382013;\ 24{,}565478)$. Точка $(2{,}8;\ 0{,}1)$ лежит далеко в стороне, расстояния до центров равны $38{,}843234$, $32{,}741695$ и $27{,}511210$. Значит, $Q_1 = 27{,}511210$ и $Q_2 = 38{,}843234$, что после умножения на $10,000$ и отбрасывания дробной части даёт $275112$ и $388432$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала $P_1$, затем $P_2$; сначала целую часть произведения $Q_1 \times 10,000$, затем целую часть произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов иллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Центр здесь определяется через сумму расстояний (а не через минимакс, как в «лабораторных» задачах) — это точка самого кластера, ищем её перебором.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности, но порог нужен заметно больше обычного: точек мало ($207$ и $473$), сгустки разрежены, и при пороге $0{,}8$ файл $А$ рассыпается на четыре куска. Устойчивый результат в файле $А$ начинается с $1{,}5$, в файле $Б$ он один и тот же при любом пороге от $0{,}5$ до $2$. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник заданного размера — например, кластеры файла $Б$ занимают около $3{,}4$ по $x$ и $3{,}7$ по $y$ при допустимых $5$ и $5$.
Отдельно про формулировку $P_1$ и $P_2$: сказано «точек на плоскости», а не «точек кластера», то есть считать надо все точки файла. Для $P_1$ это ничего не меняет (в круге радиуса $0{,}7$ лежат только свои), а для $P_2$ разница существенная: далёкий второй кластер целиком попадает в «не менее $1{,}3$».
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-17_A.ods')
ca = clusters(A, 1.5)
cb, cs = center(max(ca, key=len)), center(min(ca, key=len))
P1 = sum(math.dist(p, cb) <= 0.7 for p in A)
P2 = sum(math.dist(p, cs) >= 1.3 for p in A)
print(P1, P2)

B = load('27-17_B.ods')
q = (1.7, 2.3)
d = [math.dist(center(c), q) for c in clusters(B, 1.0)]
print(int(min(d) * 10000), int(max(d) * 10000))
Результаты для файла $А$. Всего $207$ точек, кластеры содержат $112$ и $95$ точек. Больший занимает область $x \in [69{,}30;\ 75{,}17]$, $y \in [23{,}13;\ 27{,}17]$, его центр — $(72{,}650608;\ 25{,}162900)$; меньший занимает $x \in [82{,}42;\ 88{,}14]$, $y \in [52{,}98;\ 57{,}03]$ с центром $(85{,}288101;\ 55{,}033462)$.
В круг радиуса $0{,}7$ вокруг центра большего кластера попадают $5$ точек вместе с самим центром, значит, $P_1 = 5$.
На расстоянии не менее $1{,}3$ от центра меньшего кластера лежат $183$ точки: $71$ из самого этого кластера и все $112$ точек соседнего, который целиком удалён более чем на $30$ единиц. Отсюда $P_2 = 183$. Если понимать формулировку иначе — считать только точки того же кластера, — получилось бы $71$; на мой взгляд, слова «точек на плоскости» указывают именно на все точки файла.
Результаты для файла $Б$. Всего $473$ точки, три кластера по $166$, $157$ и $150$ точек с центрами $(14{,}775198;\ 37{,}051204)$, $(13{,}883750;\ 30{,}908588)$ и $(15{,}382013;\ 24{,}565478)$. Точка $(1{,}7;\ 2{,}3)$ лежит далеко в стороне, расстояния до центров равны $37{,}129597$, $31{,}094937$ и $26{,}133293$. Значит, $Q_1 = 26{,}133293$ и $Q_2 = 37{,}129597$, что после умножения на $10,000$ и отбрасывания дробной части даёт $261332$ и $371295$.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям.
В ответе запишите четыре числа через запятую: сначала целую часть абсолютного значения произведения $P_1 \times 10,000$, затем целую часть абсолютного значения произведения $P_2 \times 10,000$; сначала целую часть абсолютного значения произведения $Q_x \times 10,000$, затем целую часть абсолютного значения произведения $Q_y \times 10,000$.
Возможные данные одного из файлов иллюстрированы графиком.
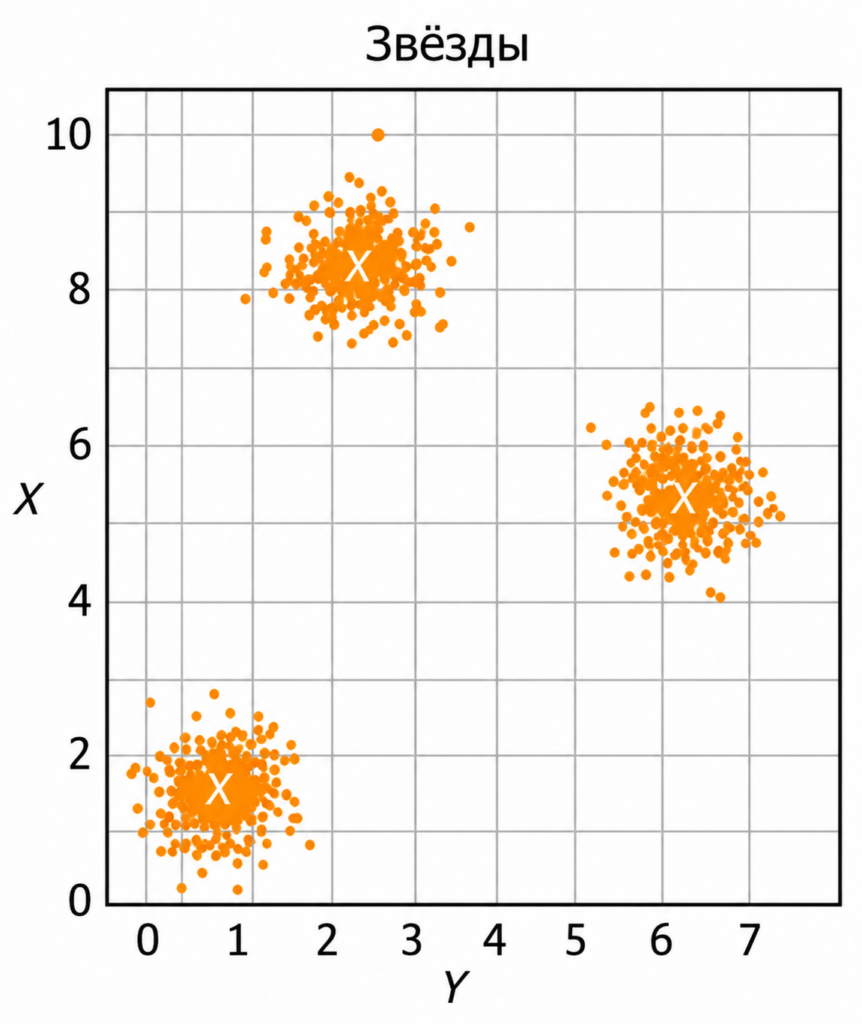
Обратите внимание на формулировку для файла $Б$: сравниваются расстояния центров до начала координат, то есть величины $\sqrt{x^2 + y^2}$, но в ответ идёт не расстояние, а координата — абсцисса самого далёкого центра и ордината самого близкого. Это два разных кластера, и путать их нельзя.
Центр здесь определяется через сумму расстояний (а не через минимакс, как в «лабораторных» задачах) — это точка самого кластера, ищем её перебором.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности, но порог нужен больше обычного: точек мало ($211$ и $505$), сгустки разрежены, и при пороге $0{,}5$ данные рассыпаются на десятки кусков. Устойчивый результат в файле $А$ начинается с $1{,}0$, в файле $Б$ — с $0{,}8$. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник заданного размера — например, кластеры файла $А$ занимают около $5{,}7$ по одной стороне и $3{,}7$ по другой при допустимых $8$ и $4$.
Три одиночные точки в файле $Б$ — это обещанные аномалии; они отсеиваются автоматически по размеру компоненты. Проверка: ближайший сосед у них удалён на $12$–$45$ единиц, тогда как внутри кластеров точки идут вплотную.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-18_A.ods')
ca = clusters(A)
sm, bg = center(min(ca, key=len)), center(max(ca, key=len))
P1, P2 = sm[0] + sm[1], bg[0] + bg[1]
print(int(abs(P1 * 10000)), int(abs(P2 * 10000)))

B = load('27-18_B.ods')                       # одиночки отсеиваются как аномалии
cen = [center(c) for c in clusters(B) if len(c) > 3]
far = max(cen, key=lambda c: math.hypot(*c))
near = min(cen, key=lambda c: math.hypot(*c))
print(int(abs(far[0] * 10000)), int(abs(near[1] * 10000)))
Результаты для файла $А$. Всего $211$ точек, кластеры содержат $100$ и $111$ точек. Меньший занимает область $x \in [16{,}87;\ 22{,}53]$, $y \in [95{,}44;\ 99{,}14]$, его центр — $(19{,}461133;\ 97{,}650624)$; больший занимает $x \in [63{,}94;\ 69{,}70]$, $y \in [84{,}54;\ 87{,}84]$ с центром $(67{,}330505;\ 86{,}247527)$. Отсюда $P_1 = 19{,}461133 + 97{,}650624 = 117{,}1117564$ и $P_2 = 67{,}330505 + 86{,}247527 = 153{,}5780321$, что после умножения на $10,000$ и отбрасывания дробной части даёт $1171117$ и $1535780$.
Результаты для файла $Б$. Всего $505$ точек: три кластера по $177$, $167$ и $158$ точек плюс три аномалии. Центры кластеров — $(23{,}822967;\ 37{,}122155)$, $(22{,}223846;\ 45{,}924376)$ и $(25{,}701352;\ 28{,}083771)$, их расстояния до начала координат равны $44{,}108821$, $51{,}019091$ и $38{,}069117$.
Самый далёкий центр — $(22{,}223846;\ 45{,}924376)$, его абсцисса $Q_x = 22{,}223846$. Самый близкий — $(25{,}701352;\ 28{,}083771)$, его ордината $Q_y = 28{,}083771$. Умножаем на $10,000$ и берём целые части: $222238$ и $280837$.
Обратите внимание, что у самого далёкого центра абсцисса как раз наименьшая из трёх — удалённость определяется обеими координатами сразу, и брать «крайний по $x$» нельзя.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям.
В ответе запишите четыре числа через запятую: сначала целую часть абсолютной величины произведения $P_1 \times 10,000$, затем целую часть абсолютной величины произведения $P_2 \times 10,000$; сначала целую часть произведения $Q_x \times 10,000$, затем целую часть произведения $Q_y \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком.
Главное отличие от привычных задач: здесь ищется антицентр — точка кластера с максимальной суммой расстояний до остальных. Это всегда точка на краю сгустка, а не в его середине. Технически меняется одна строчка: вместо min берём max по той же сумме.
Второе, на что стоит смотреть внимательно: для файла $Б$ сравниваются расстояния антицентров до начала координат, то есть величины $\sqrt{x^2 + y^2}$, но в ответ идёт не расстояние, а координата — абсцисса самого далёкого антицентра и ордината самого близкого. Это два разных кластера.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности, но порог нужен больше обычного: точек мало ($211$ и $505$), сгустки разрежены, и при пороге $0{,}5$ данные рассыпаются на десятки кусков. Устойчивый результат в файле $А$ начинается с $1{,}0$, в файле $Б$ — с $0{,}8$. Проверяем: число кластеров совпадает с условием, и каждый укладывается в прямоугольник заданного размера — например, кластеры файла $А$ занимают около $5{,}7$ по одной стороне и $3{,}7$ по другой при допустимых $8$ и $4$.
Три одиночные точки в файле $Б$ — это обещанные аномалии; они отсеиваются автоматически по размеру компоненты.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def anticenter(c):                            # максимум суммы расстояний
    return max(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-19_A.ods')
ca = clusters(A)
sm, bg = anticenter(min(ca, key=len)), anticenter(max(ca, key=len))
P1, P2 = sm[0] + sm[1], bg[0] + bg[1]
print(int(abs(P1 * 10000)), int(abs(P2 * 10000)))

B = load('27-19_B.ods')                       # одиночки отсеиваются как аномалии
ac = [anticenter(c) for c in clusters(B) if len(c) > 3]
far = max(ac, key=lambda c: math.hypot(*c))
near = min(ac, key=lambda c: math.hypot(*c))
print(int(abs(far[0] * 10000)), int(abs(near[1] * 10000)))
Результаты для файла $А$. Всего $211$ точек, кластеры содержат $100$ и $111$ точек. Меньший занимает область $x \in [16{,}87;\ 22{,}53]$, $y \in [95{,}44;\ 99{,}14]$, его антицентр — $(16{,}998415;\ 95{,}672752)$; больший занимает $x \in [63{,}94;\ 69{,}70]$, $y \in [84{,}54;\ 87{,}84]$ с антицентром $(63{,}940626;\ 87{,}777510)$. Оба лежат у самого края своих сгустков, как и должно быть. Отсюда $P_1 = 16{,}998415 + 95{,}672752 = 112{,}6711664$ и $P_2 = 63{,}940626 + 87{,}777510 = 151{,}7181367$, что после умножения на $10,000$ и отбрасывания дробной части даёт $1126711$ и $1517181$.
Результаты для файла $Б$. Всего $505$ точек: три кластера по $177$, $167$ и $158$ точек плюс три аномалии. Антицентры кластеров — $(22{,}170759;\ 39{,}658913)$, $(20{,}526123;\ 43{,}733457)$ и $(28{,}463219;\ 28{,}234534)$, их расстояния до начала координат равны $45{,}435360$, $48{,}310837$ и $40{,}091692$.
Самый далёкий антицентр — $(20{,}526123;\ 43{,}733457)$, его абсцисса $Q_x = 20{,}526123$. Самый близкий — $(28{,}463219;\ 28{,}234534)$, его ордината $Q_y = 28{,}234534$. Умножаем на $10,000$ и берём целые части: $205261$ и $282345$.
Обратите внимание, что у самого далёкого антицентра абсцисса как раз наименьшая из трёх — удалённость определяется обеими координатами сразу, и брать «крайний по $x$» нельзя.
20
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям.
В ответе запишите четыре числа через запятую: сначала целую часть абсолютной величины произведения $P_x \times 10,000$, затем целую часть абсолютной величины произведения $P_y \times 10,000$; сначала целую часть произведения $Q_1 \times 10,000$, затем целую часть произведения $Q_2 \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком.
Обратите внимание: $P_x$ и $P_y$ берутся независимо друг от друга — это минимум по абсциссам и минимум по ординатам, а не координаты одной и той же точки. В данном файле они случайно принадлежат одному центру, но полагаться на это нельзя.
Центр здесь определяется через сумму расстояний — это точка самого кластера, ищем её перебором, а не как среднее арифметическое координат.
Кластеризация. Прямоугольники не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности. В файле $А$ результат устойчив при любом пороге от $0{,}5$ до $2$: две группы по $92$ и $131$ точке. В файле $Б$ порог $0{,}5$ мал — от кластеров отрываются лишние одиночки; начиная с $1{,}0$ остаются ровно три группы ($392$, $111$, $96$) и три одиночные точки, то есть обещанные аномалии. Проверяем размеры: каждый кластер укладывается в прямоугольник заданного размера.
Для $Q_2$ нужно в каждом кластере найти самую далёкую от его центра точку и взять наибольшее из этих значений по всем кластерам. Здесь легко ошибиться и посчитать наибольшее расстояние между любыми двумя точками кластера — в условии речь именно о расстоянии от центра.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.0):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-20_A.ods')
cs = [center(c) for c in clusters(A)]
Px, Py = min(p[0] for p in cs), min(p[1] for p in cs)
print(int(abs(Px * 10000)), int(abs(Py * 10000)))

B = load('27-20_B.ods')                       # одиночки отсеиваются как аномалии
cl = sorted((c for c in clusters(B) if len(c) > 3), key=len)
cen = [center(c) for c in cl]
Q1 = math.dist(cen[0], cen[-1])               # min и max по количеству точек
Q2 = max(max(math.dist(cn, p) for p in c) for c, cn in zip(cl, cen))
print(int(Q1 * 10000), int(Q2 * 10000))
Результаты для файла $А$. Всего $223$ точки, кластеры содержат $92$ и $131$ точку. Первый занимает область $x \in [5{,}47;\ 8{,}48]$, $y \in [11{,}46;\ 13{,}00]$ с центром $(7{,}0391548;\ 12{,}3587258)$, второй — $x \in [2{,}09;\ 5{,}53]$, $y \in [5{,}29;\ 6{,}96]$ с центром $(3{,}8471735;\ 6{,}1225014)$. Минимальная абсцисса $P_x = 3{,}8471735$, минимальная ордината $P_y = 6{,}1225014$, что после умножения на $10,000$ и отбрасывания дробной части даёт $38471$ и $61225$.
Результаты для файла $Б$. Всего $602$ точки: три кластера по $392$, $111$ и $96$ точек плюс три аномалии. Центры кластеров — $(11{,}555522;\ 14{,}5042082)$ для кластера из $392$ точек, $(14{,}6275088;\ 23{,}5024317)$ для кластера из $111$ точек и $(21{,}3946551;\ 24{,}7510816)$ для кластера из $96$ точек. Расстояние между центрами самого маленького и самого большого кластеров $Q_1 = 14{,}2058775$.
Максимальные удаления точек от своего центра по кластерам равны $2{,}529975$, $2{,}303851$ и $2{,}235668$, наибольшее из них $Q_2 = 2{,}5299752$. Умножаем на $10,000$ и берём целые части: $142058$ и $25299$.
20