
 Карточки
 Тесты


 Главная
 Курсы
 Подписка
27. Программирование: #298916

Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной $H$ и $W$, причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
В ответе запишите четыре числа через запятую: сначала целую часть абсолютного значения произведения $P_x \times 10,000$, затем целую часть абсолютного значения произведения $P_y \times 10,000$; сначала целую часть абсолютного значения произведения $Q_x \times 10,000$, затем целую часть абсолютного значения произведения $Q_y \times 10,000$.
Возможные данные одного из файлов проиллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
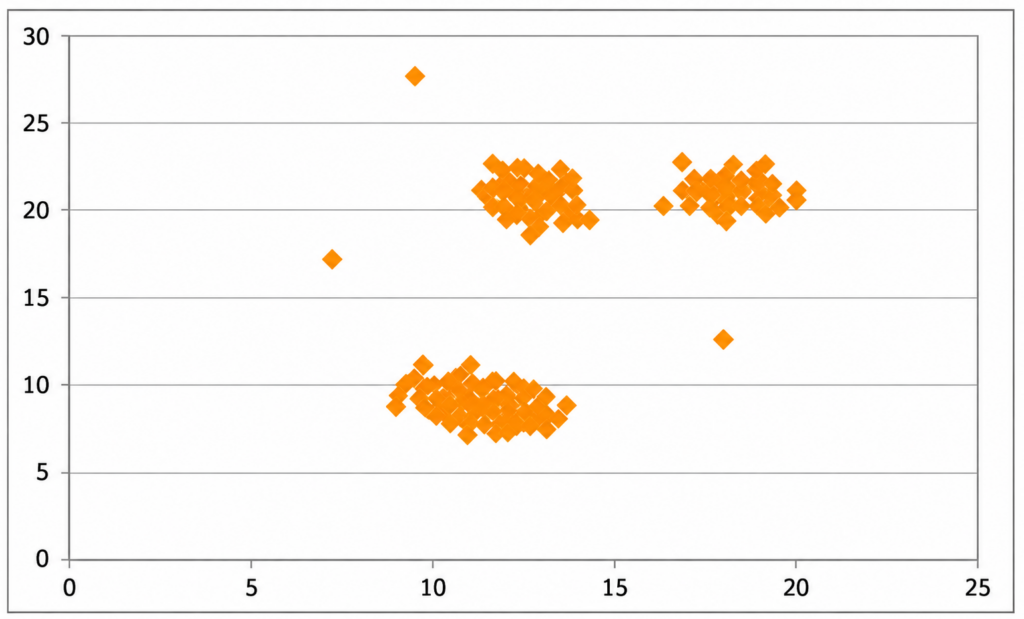
Обратите внимание на две формулировки, которые легко прочесть невнимательно. Во-первых, $P_x$ и $P_y$ берутся независимо друг от друга — это максимум по абсциссам и максимум по ординатам, а не координаты одной точки. Во-вторых, для файла $Б$ считается разность, а не расстояние: берётся модуль результата, так что порядок вычитания на ответ не влияет.
Прямоугольники не пересекаются, значит, кластеры разделены в пространстве, и хитрый алгоритм не нужен: достаточно найти «щели» между сгустками точек. Определение центра здесь геометрическое — это точка самого кластера (а не произвольная точка плоскости), для которой сумма расстояний до остальных минимальна. Ищем её перебором по точкам кластера, а не как среднее арифметическое координат: это самая частая ошибка в задании.
Универсальный способ разбиения — компоненты связности: объединяем точки, отстоящие друг от друга меньше чем на некоторый порог. Внутри плотного сгустка соседи всегда ближе порога, а между кластерами расстояние заведомо больше, поскольку прямоугольники не пересекаются. Порог проверяем по результату: он должен дать ровно столько кластеров, сколько обещано в условии, и каждый должен укладываться в прямоугольник заданного размера.
Файл $А$. Всего $201$ точка (первая строка — заголовок $X$ $Y$). Разбиение устойчиво к выбору порога от $1$ до $2$: группы из $83$ и $118$ точек. Первая занимает область $x \in [2{,}78;\ 4{,}18]$, $y \in [3{,}96;\ 7{,}15]$, вторая — $x \in [4{,}18;\ 5{,}69]$, $y \in [16{,}66;\ 19{,}80]$. Обе укладываются в прямоугольник $6 \times 4{,}5$. По абсциссам кластеры почти совпадают, разделяет их именно ордината — делить по $x$ было бы ошибкой. Аномалий в файле $А$ нет, лишних одиночных точек алгоритм не находит.
Файл $Б$. Здесь $601$ точка. Разбиение снова устойчиво: группы размерами $372$, $127$, $99$ и три одиночные точки — это и есть обещанные аномалии. Проверка: у каждой из них ближайший сосед находится на расстоянии больше $22$, тогда как внутри кластеров точки идут вплотную. Кластер с минимальным количеством точек — тот, где их $99$, с максимальным — где $372$; разности координат считаются именно между их центрами.
import openpyxl, math

def load(name):
    ws = openpyxl.load_workbook(name).active
    return [(r[0], r[1]) for r in ws.iter_rows(min_row=2, values_only=True)
            if r[0] is not None]          # min_row=2 — пропускаем заголовок

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps=1.5):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

A = load('27-05_A.xlsx')
cs = [center(c) for c in clusters(A) if len(c) > 3]
Px, Py = max(p[0] for p in cs), max(p[1] for p in cs)
print(int(abs(Px * 10000)), int(abs(Py * 10000)))

B = load('27-05_B.xlsx')                  # одиночки отсеиваются как аномалии
cl = sorted((c for c in clusters(B) if len(c) > 3), key=len)
c_min, c_max = center(cl[0]), center(cl[-1])
Qx, Qy = c_min[0] - c_max[0], c_min[1] - c_max[1]
print(int(abs(Qx * 10000)), int(abs(Qy * 10000)))
Результаты для файла $А$. Центры кластеров: $(3{,}4396093;\ 5{,}7248664)$ и $(4{,}9959134;\ 18{,}2737359)$. Максимальная абсцисса $P_x = 4{,}9959134$, максимальная ордината $P_y = 18{,}2737359$. После умножения на $10,000$ и отбрасывания дробной части получаем $49959$ и $182737$.
Результаты для файла $Б$. Центры кластеров: $(18{,}5126688;\ 21{,}1251054)$ для кластера из $99$ точек, $(12{,}7758796;\ 20{,}719154)$ для кластера из $127$ точек и $(11{,}5299174;\ 8{,}8858558)$ для кластера из $372$ точек. Считаем разности между центрами самого маленького и самого большого кластеров: $Q_x = 18{,}5126688 — 11{,}5299174 = 6{,}9827514$ и $Q_y = 21{,}1251054 — 8{,}8858558 = 12{,}2392496$. Умножаем на $10,000$ и берём целые части модулей: $69827$ и $122392$.
 20
