
 Карточки
 Тесты


 Главная
 Курсы
 Подписка
ЕГЭ, Информатика: 23. Алгоритмические задачи, связанные с анализом графов: все задания

В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной кратчайшего пути понимается минимальная сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
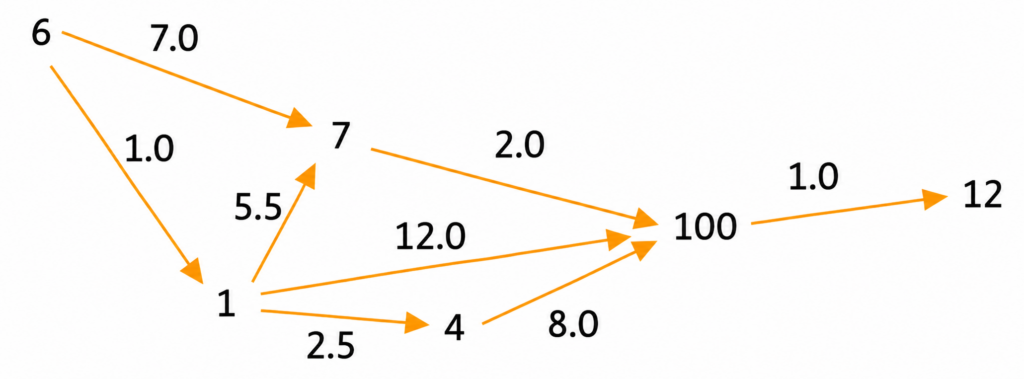
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведенного примера верным ответом будет $7$.
Что важно вычитать из условия, прежде чем писать код:
- граф ориентированный и ациклический ($DAG$), веса положительные — значит, подходит любой из трёх стандартных инструментов: динамика по ациклическому графу (рекурсия с запоминанием), алгоритм Дейкстры, релаксация рёбер (Беллман–Форд);
- номера вершин не идут подряд ($L,M≤1000$), поэтому граф удобнее хранить в словаре, а не в списке по индексам;
- разделители — произвольное число пробелов и табуляций, поэтому строки разбираем через split() без аргументов;
- веса вещественные, читаем через float(); в ответ идёт целая часть, при положительных весах int() её и даёт;
- рёбер не более $200$, так что вопрос эффективности не стоит — важна корректность;
- существование пути гарантируется, обработка «пути нет» не нужна.
Проверка на примере из условия. Из $1$ в $100$ ведут три пути: $1→7→100$ длиной $5,5+2,0=7,5$; $1→100$ напрямую длиной $12,0$; $1→4→100$ длиной $2,5+8,0=10,5$. Минимум $7,5$, целая часть $7$. Рёбра $6→7$, $6→1$, $100→12$ на ответ не влияют.
Способ 1: рекурсия по ациклическому графу с запоминанием (динамическое программирование)
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)

g = {} # словарь: вершина -> список (сосед, вес)
for line in open('demo_23.txt'):
s = line.split() # split() без аргумента съедает любые пробелы и табуляции
if len(s) < 3: # пропускаем пустые строки
continue
a, b, w = int(s[0]), int(s[1]), float(s[2])
g.setdefault(a, []).append((b, w))

@lru_cache(None)
def f(v): # длина кратчайшего пути из v в 100
if v == 100:
return 0
best = float('inf')
for u, w in g.get(v, []):
best = min(best, w + f(u))
return best

print(int(f(1))) # целая часть длины
Альтернатива — алгоритм Дейкстры (в приложенном файле дан в комментарии). Для контроля я прогнал три разных алгоритма, все дали одно и то же.
Способ 2: алгоритм Дейкстры с очередью с приоритетом
import heapq
g = {}
for line in open('demo_23.txt'):
s = line.split()
if len(s) < 3:
continue
a, b, w = int(s[0]), int(s[1]), float(s[2])
g.setdefault(a, []).append((b, w))
g.setdefault(b, [])
d = {v: float('inf') for v in g}
d[1] = 0
q = [(0, 1)]
while q:
dv, v = heapq.heappop(q)
if dv > d[v]:
continue
for u, w in g[v]:
if dv + w < d[u]:
d[u] = dv + w
heapq.heappush(q, (d[u], u))
print(int(d[100])) 20

В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной кратчайшего пути понимается минимальная сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведенного примера верным ответом будет $7$.
Граф ациклический, поэтому функция $f(v)$ — «длина кратчайшего пути из $v$ в $100$» — определяется рекуррентно: $f(100) = 0$, а для остальных вершин $f(v) = min(w + f(u))$ по всем рёбрам $v → u$. Если из $v$ рёбер нет и $v ≠ 100$, пути не существует — возвращаем $+∞$. Запоминание результатов (lru_cache) делает решение мгновенным.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_1.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
@lru_cache(None)
def f(v):                                # кратчайший путь из v в 100
    if v == 100:
        return 0
    best = float('inf')                  # тупик: пути нет
    for u, w in g.get(v, []):
        best = min(best, w + f(u))
    return best
print(int(f(1)))
Второй способ — алгоритм Дейкстры (веса положительные, поэтому он применим):
import heapq
g = {}
for line in open('23_1.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
    g.setdefault(b, [])
d = {v: float('inf') for v in g}
d[1] = 0
q = [(0, 1)]
while q:
    dv, v = heapq.heappop(q)
    if dv > d[v]:
        continue
    for u, w in g[v]:
        if dv + w < d[u]:
            d[u] = dv + w
            heapq.heappush(q, (d[u], u))
print(int(d[100]))
Длина кратчайшего пути $20809,6$; путь $1 → 603 → 693 → 809 → 100$ (четыре ребра).
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество различных путей из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной кратчайшего пути понимается минимальная сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера верным ответом будет $3$ (пути $1–7–100$, $1–100$ и $1–4–100$).
Веса рёбер здесь не нужны — считаем только структуру графа. Пусть $f(v)$ — количество путей из $v$ в $100$. Тогда $f(100) = 1$, а для остальных вершин $f(v)$ равно сумме $f(u)$ по всем рёбрам $v → u$; для тупика сумма пуста и равна $0$.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}
for line in open('23_2.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # вес ребра не нужен
    g.setdefault(a, []).append(b)
@lru_cache(None)
def f(v):                                # число путей из v в 100
    if v == 100:
        return 1
    return sum(f(u) for u in g.get(v, []))   # тупик даёт 0
print(f(1))В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины самого длинного пути из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведенного примера верным ответом будет $12$.
В ациклическом графе самый длинный путь ищется той же рекурсией, что и кратчайший, с заменой $min$ на $max$. Принципиально важна база для тупиков: $−∞$, а не $0$, иначе путь, упирающийся в тупик, будет посчитан как «дошедший до $100$». Алгоритм Дейкстры для поиска самого длинного пути не подходит — его жадный выбор корректен только для минимума; вместо него можно использовать обход вершин в топологическом порядке.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_3.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
@lru_cache(None)
def f(v):                                # самый длинный путь из v в 100
    if v == 100:
        return 0
    best = float('-inf')                 # тупик: пути нет!
    for u, w in g.get(v, []):
        best = max(best, w + f(u))
    return best
print(int(f(1)))
Длина самого длинного пути $170717,7$; путь содержит $25$ рёбер: $1 → 214 → 932 → 841 → 222 → 435 → 530 → 306 → 361 → 108 → 3 → 969 → 60 → 851 → 137 → 449 → 535 → 235 → 880 → 161 → 471 → 279 → 527 → 594 → 294 → 478 → 100$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$, проходящего через вершину с номером $790$. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при условии прохождения через вершину $4$ верным ответом будет $10$ (единственный такой путь $1–4–100$ имеет длину $10,5$).
Любой путь из $1$ в $100$, проходящий через $K$, распадается на две части: $1 → … → K$ и $K → … → 100$. В ациклическом графе эти части не могут иметь общих вершин, кроме $K$, поэтому минимальная длина всего пути равна сумме минимальных длин частей: $d(1, K) + d(K, 100)$. Достаточно написать одну функцию «кратчайший путь из src в dst» и вызвать её дважды.
Первый способ
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_4.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
def short(src, dst):                     # длина кратчайшего пути src -> dst
    @lru_cache(None)
    def f(v):
        if v == dst:
            return 0
        best = float('inf')              # тупик: пути нет
        for u, w in g.get(v, []):
            best = min(best, w + f(u))
        return best
    return f(src)
K = 790
print(int(short(1, K) + short(K, 100)))
Второй способ — два запуска алгоритма Дейкстры (из $1$ и из $K$). Словарь $g$ при этом должен содержать все вершины, в том числе те, что встречаются только как конец ребра:
import heapq
g = {}
for line in open('23_4.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
    g.setdefault(b, [])                  # все вершины должны быть ключами
def dijkstra(src):                       # словарь расстояний от src
    d = {v: float('inf') for v in g}
    d[src] = 0
    q = [(0, src)]
    while q:
        dv, v = heapq.heappop(q)
        if dv > d[v]:
            continue
        for u, w in g[v]:
            if dv + w < d[u]:
                d[u] = dv + w
                heapq.heappush(q, (d[u], u))
    return d
K = 790
print(int(dijkstra(1)[K] + dijkstra(K)[100]))
$d(1, 790) = 11989,8; d(790, 100) = 2854,1$; сумма $14843,9$. Путь: $1 → 321 → 664 → 656 → 388 → 790 → 227 → 100$ ($7$ рёбер).
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество различных путей из вершины с номером $1$ в вершину с номером $100$, проходящих через вершину с номером $455$ и не проходящих через вершину с номером $704$. Существование хотя бы одного такого пути гарантируется. Два пути считаются различными, если они отличаются хотя бы одним ребром.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при условии «через вершину $7$ и не через вершину $4$» верным ответом будет $1$ (путь $1–7–100$). Всего путей из $1$ в $100$ три, из них через вершину $7$ проходит один, не проходят через вершину $4$ два.
«Не проходящих через $M$» означает, что вершину $M$ можно просто вырезать из графа: возвращать $0$, как только рекурсия в неё попала (или не добавлять рёбра с $M$ при чтении файла). «Проходящих через $K$» — путь распадается на две части, и число путей равно произведению: (число путей $1 → K$ без $M$) × (число путей $K → 100$ без $M$). Веса рёбер не нужны.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}
for line in open(’23_5.txt’):
s = line.split()
if len(s) < 3:
continue
a, b = int(s[0]), int(s[1]) # вес ребра не нужен
g.setdefault(a, []).append(b)
def cnt(src, dst, banned): # число путей src -> dst, минуя banned
@lru_cache(None)
def f(v):
if v == banned: # запрещённая вершина «вырезана»
return 0
if v == dst:
return 1
return sum(f(u) for u in g.get(v, []))
return f(src)
K, M = 455, 704
print(cnt(1, K, M) * cnt(K, 100, M))
Контроль: тот же результат даёт разность (число путей через $K$) − (число путей через $K$ и через $M$) = $2 092 845 − 1 523 340 = 569 505$; второй способ требует знать, какая из вершин $K$ и $M$ встречается на пути раньше, поэтому вырезание $M$ надёжнее.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите кратчайший путь из вершины с номером $1$ в вершину с номером $100$. Гарантируется, что такой путь существует и является единственным. В ответе запишите количество рёбер, составляющих этот путь. Под длиной пути понимается сумма весов рёбер, составляющих путь; кратчайшим считается путь минимальной длины.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера кратчайший путь $1–7–100$ имеет длину $7,5$ и состоит из двух рёбер, поэтому верным ответом будет $2$.
Рекурсия та же, что для длины кратчайшего пути, но функция возвращает пару (длина, число рёбер). Кортежи в Python сравниваются лексикографически: сначала по длине, при равенстве — по числу рёбер, поэтому $min$ по парам находит именно кратчайший по весу путь, а вторая компонента — количество его рёбер. Единственность кратчайшего пути гарантирует однозначность ответа. Тот же приём с кортежем (длина, путь) восстанавливает и сам путь.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_6.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
@lru_cache(None)
def f(v):                                # (длина, число рёбер) кратчайшего пути v -> 100
    if v == 100:
        return (0, 0)
    best = (float('inf'), 0)
    for u, w in g.get(v, []):
        L, k = f(u)
        best = min(best, (w + L, k + 1))   # пары сравниваются по длине, затем по числу рёбер
    return best
print(f(1)[1])
Вариант с восстановлением пути:
@lru_cache(None)
def f(v):                                # (длина, кортеж вершин) кратчайшего пути v -> 100
    if v == 100:
        return (0, (100,))
    best = (float('inf'), ())
    for u, w in g.get(v, []):
        L, p = f(u)
        best = min(best, (w + L, (v,) + p))
    return best
L, path = f(1)
print(path)                              # сам путь — удобно для проверки
print(len(path) - 1)                     # рёбер на одно меньше, чем вершин
Кратчайший путь длиной $14722,4$: $1 → 785 → 650 → 753 → 903 → 913 → 727 → 62 → 255 → 100$ — десять вершин, девять рёбер.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной кратчайшего пути понимается минимальная сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при условии «не через вершину $7$» верным ответом будет $10$: из оставшихся путей $1–100$ (длина $12,0$) и $1–4–100$ (длина $10,5$) кратчайший имеет длину $10,5$.
Запрещённая вершина $M$ «вырезается» из графа: как только рекурсия попадает в $M$, возвращаем $+∞$ — «пути нет». Всё остальное — базовая рекурсия для кратчайшего пути. Проверка запрета обязана стоять раньше проверки $v == 100$, чтобы формулировка с $M = 100$ не ломала программу.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_7.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
M = 330
@lru_cache(None)
def f(v):                                # кратчайший путь v -> 100, минуя M
    if v == M:                           # запрещённая вершина: пути нет
        return float('inf')
    if v == 100:
        return 0
    best = float('inf')
    for u, w in g.get(v, []):
        best = min(best, w + f(u))
    return best
print(int(f(1)))
Второй способ — не читать рёбра, инцидентные $M$ (дальше — обычная программа для кратчайшего пути):
M = 330
g = {}
for line in open('23_7.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    if a == M or b == M:                 # рёбра запрещённой вершины не читаем
        continue
    g.setdefault(a, []).append((b, w))
Длина $14631,7$; путь $1 → 921 → 413 → 675 → 627 → 350 → 682 → 100$. Безусловный кратчайший путь $1 → 330 → 37 → 826 → 86 → 682 → 100$ имеет длину $12718,2$ и проходит через $330$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество различных путей из вершины с номером $1$ в вершину с номером $100$, состоящих ровно из $8$ рёбер. Существование хотя бы одного такого пути гарантируется. Два пути считаются различными, если они отличаются хотя бы одним ребром.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при условии «ровно из $2$ рёбер» верным ответом будет $2$ (пути $1–7–100$ и $1–4–100$); путь ровно из одного ребра один ($1–100$), путей из трёх и более рёбер нет.
У функции появляется второй параметр — сколько рёбер ещё нужно пройти: $f(v, k)$ — число путей из $v$ в $100$ ровно из $k$ рёбер. База: при $k = 0$ путь завершён и годится только если мы стоим в $100$. Переход: $f(v, k) = Σ f(u, k − 1)$ по рёбрам $v → u$. Запоминание работает по паре ($v, k$). Веса не нужны.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список соседей
for line in open('23_8.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # вес ребра не нужен
    g.setdefault(a, []).append(b)
N = 8
@lru_cache(None)
def f(v, k):                             # число путей v -> 100 ровно из k рёбер
    if k == 0:
        return 1 if v == 100 else 0
    if v == 100:                         # в вершине 100 путь заканчивается
        return 0
    return sum(f(u, k - 1) for u in g.get(v, []))
print(f(1, N))
Для справки — распределение путей $1 → 100$ по числу рёбер в этом файле: $4$ ребра — $4$ пути, $5 — 30$, $6 — 206$, $7 — 1007$, $8 — 4224$, $9 — 15003$, $10 — 45801, … , 27 — 240$; всего $17 270 047$ путей.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Известно, что существует ровно одна вершина, отличная от вершин с номерами $1$ и $100$, через которую проходят все пути из вершины с номером $1$ в вершину с номером $100$. Найдите и запишите в ответе номер этой вершины. Существование хотя бы одного такого пути гарантируется.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера для пары вершин $1$ и $100$ такой вершины нет (есть путь $1–100$ из одного ребра), а для пары вершин $6$ и $12$ такой вершиной является вершина $100$: все четыре пути из $6$ в $12$ ($6–7–100–12, 6–1–7–100–12, 6–1–100–12, 6–1–4–100–12$) проходят через неё.
Вершина $v$ обязательна тогда и только тогда, когда после её удаления путей из $1$ в $100$ не остаётся. Значит, достаточно для каждой вершины (кроме $1$ и $100$) посчитать число путей, минуя её, и напечатать те, для которых получился $0$. Заметьте, что множество вершин нужно собрать из обеих колонок файла: вершина, встречающаяся только как конец ребра, не является ключом словаря $g$.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список соседей
for line in open('23_9.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # вес ребра не нужен
    g.setdefault(a, []).append(b)
def cnt(banned):                         # число путей 1 -> 100, минуя banned
    @lru_cache(None)
    def f(v):
        if v == banned:
            return 0
        if v == 100:
            return 1
        return sum(f(u) for u in g.get(v, []))
    return f(1)
verts = set(g)                           # все вершины графа
for v in g:
    verts |= set(g[v])
for v in sorted(verts):
    if v not in (1, 100) and cnt(v) == 0:   # без v путей не осталось
        print(v)
Второй способ — через произведение: $v$ обязательна, если (число путей $1 → v$) × (число путей $v → 100$) равно общему числу путей $1 → 100$. Продолжение программы после определения cnt и verts:
total = cnt(None)                        # все пути 1 -> 100
def paths(src, dst):                     # число путей src -> dst
    @lru_cache(None)
    def f(v):
        if v == dst:
            return 1
        return sum(f(u) for u in g.get(v, []))
    return f(src)
for v in sorted(verts):
    if v not in (1, 100) and paths(1, v) * paths(v, 100) == total:
        print(v)
Все $10 083 038$ путей из $1$ в $100$ проходят через вершину $544$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество различных кратчайших путей из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь; кратчайшим считается путь минимальной длины. Два пути считаются различными, если они отличаются хотя бы одним ребром.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера верным ответом будет $1$: кратчайший путь $1–7–100$ (длина $7,5$) единственный, остальные пути длиннее.
Функция возвращает пару (длина кратчайшего пути из $v$ в $100$, число таких путей). При переборе рёбер $v → u$ возможны три случая: путь через $u$ короче найденного — запоминаем новую длину и берём счётчик $u$; такой же длины — прибавляем счётчик $u$; длиннее — пропускаем. База: ($0, 1$) для вершины $100$. Тупик автоматически даёт ($+∞, 0$) и на счёт не влияет.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_10.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
@lru_cache(None)
def f(v):                                # (длина кратчайшего пути v -> 100, число таких путей)
    if v == 100:
        return (0, 1)
    best, cnt = float('inf'), 0
    for u, w in g.get(v, []):
        L, c = f(u)
        if w + L < best:                 # нашли путь короче — счётчик заново
            best, cnt = w + L, c
        elif w + L == best:              # ничья — добавляем
            cnt += c
    return (best, cnt)
print(f(1)[1])
Второй способ — сначала найти длину кратчайшего пути d(1), затем посчитать число путей ровно такой длины рекурсией с двумя параметрами (как в задании 8, но «остаток» — длина, а не число рёбер):
@lru_cache(None)
def d(v):                                # длина кратчайшего пути v -> 100
    if v == 100:
        return 0
    return min([w + d(u) for u, w in g.get(v, [])], default=float('inf'))
@lru_cache(None)
def cnt(v, rest):                        # число путей v -> 100 длиной ровно rest
    if v == 100:
        return 1 if rest == 0 else 0
    return sum(cnt(u, rest - w) for u, w in g.get(v, []) if rest - w >= 0)
print(cnt(1, d(1)))
Длина кратчайшего пути $62,0$; пять путей: $1 → 351 → 776 → 927 → 914 → 100; 1 → 351 → 356 → 172 → 292 → 914 → 100; 1 → 330 → 91 → 277 → 292 → 914 → 100; 1 → 330 → 344 → 213 → 971 → 927 → 914 → 100; 1 → 330 → 541 → 277 → 292 → 914 → 100$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$, состоящего не более чем из $5$ рёбер. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при ограничении «не более чем из $1$ ребра» верным ответом будет $12$ (единственный такой путь $1–100$), а при ограничении «не более чем из $2$ рёбер» — $7$ (кратчайший из путей $1–100, 1–7–100, 1–4–100$ имеет длину $7,5$).
У функции два параметра: $f(v, k)$ — длина кратчайшего пути из $v$ в $100$, использующего не более $k$ рёбер. Переход: $f(v, k) = min(w + f(u, k − 1))$ по рёбрам $v → u$. Порядок баз важен: сначала «мы в $100$ — путь найден, остаток рёбер не имеет значения», и только потом «рёбра кончились — пути нет». Если поменять их местами, пути ровно из $N$ рёбер будут отброшены.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_11.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
N = 5
@lru_cache(None)
def f(v, k):                             # кратчайший v -> 100, <= k рёбер
    if v == 100:                         # дошли: остаток рёбер не важен
        return 0
    if k == 0:                           # рёбра кончились, а мы не в 100
        return float('inf')
    best = float('inf')
    for u, w in g.get(v, []):
        best = min(best, w + f(u, k - 1))
    return best
print(int(f(1, N)))
Второй способ — $N$ раундов релаксации рёбер (алгоритм Беллмана–Форда): после $i$ раундов $d[v]$ равно длине кратчайшего пути в $v$ не более чем из $i$ рёбер, если каждый раунд использует расстояния только предыдущего раунда:
edges = []
for line in open('23_11.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    edges.append((int(s[0]), int(s[1]), float(s[2])))
N = 5
d = {1: 0}                               # расстояния путями <= i рёбер
for i in range(N):
    nd = dict(d)                         # раунд i+1 — по итогам раунда i
    for a, b, w in edges:
        if a in d and d[a] + w < nd.get(b, float('inf')):
            nd[b] = d[a] + w
    d = nd
print(int(d[100]))
Длина $18555,6$; путь $1 → 767 → 78 → 55 → 62 → 100$ (ровно $5$ рёбер). Безусловный кратчайший путь имеет длину $13687,7$ и состоит из $6$ рёбер; лучший путь не более чем из $4$ рёбер имеет длину $23290,9$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Для каждого пути из вершины с номером $1$ в вершину с номером $100$ рассмотрим наибольший из весов рёбер, составляющих этот путь. Среди всех таких путей найдите путь, для которого эта величина минимальна, и запишите в ответе целую часть найденного наибольшего веса. Существование хотя бы одного пути из вершины $1$ в вершину $100$ гарантируется.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера наибольшие веса рёбер на путях таковы: $1–7–100 — 5,5$; $1–100 — 12,0$; $1–4–100 — 8,0$. Минимальная из этих величин равна $5,5$, поэтому верным ответом будет $5$.
Величина, которую мы минимизируем, — не сумма весов, а максимум весов на пути. Рекурсия та же, что для кратчайшего пути, но вместо $w + f(u)$ стоит $max(w, f(u))$: наибольшее ребро на пути «$v → u → … → 100$» — это большее из ребра $v → u$ и наибольшего ребра на продолжении. Приём общий: динамика по ациклическому графу работает для любой операции вдоль пути, которая не убывает при добавлении ребра (сумма, максимум, произведение положительных чисел).
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_12.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
@lru_cache(None)
def f(v):                                # min наибольшего ребра на пути
    if v == 100:
        return 0
    best = float('inf')
    for u, w in g.get(v, []):
        best = min(best, max(w, f(u)))   # вместо w + f(u) — max(w, f(u))
    return best
print(int(f(1)))
Второй способ — метод порога: ответ равен наименьшему весу $T$, при котором вершина $100$ достижима из $1$ по рёбрам веса не более $T$. Перебираем все различные веса по возрастанию и проверяем достижимость обходом (можно и двоичным поиском):
def reachable(T):                        # путь 1 -> 100 по рёбрам <= T
    seen = {1}
    stack = [1]
    while stack:
        v = stack.pop()
        for u, w in g.get(v, []):
            if w <= T and u not in seen:
                seen.add(u)
                stack.append(u)
    return 100 in seen
weights = sorted(set(w for v in g for u, w in g[v]))
for T in weights:                        # первый порог, при котором путь есть
    if reachable(T):
        print(int(T))
        break
Наибольшее ребро на оптимальном пути весит $2667,8$; путь $1 → 766 → 581 → 797 → 378 → 41 → 375 → 110 → 100$. Для сравнения: на кратчайшем по сумме пути (длина $9169,3$) наибольшее ребро весит $4130,7$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите вершину, достижимую из вершины с номером $1$, для которой длина кратчайшего пути из вершины $1$ в эту вершину наибольшая. Гарантируется, что такая вершина единственная. В ответе запишите номер этой вершины. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера длины кратчайших путей из вершины $1$ таковы: в вершину $4 — 2,5$; в вершину $7 — 5,5$; в вершину $100 — 7,5$; в вершину $12 — 8,5$. Наибольшая из них — $8,5$, поэтому верным ответом будет $12$.
Алгоритм Дейкстры за один запуск даёт расстояния от вершины $1$ до всех вершин — остаётся выбрать максимум среди конечных. Две тонкости: словарь $g$ должен содержать все вершины, включая те, у которых нет исходящих рёбер (именно такой оказывается самая удалённая вершина в этом файле), а недостижимые вершины (расстояние $+∞$) из максимума исключаются.
import heapq
g = {}
for line in open('23_13.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
    g.setdefault(b, [])                  # тупики тоже нужны!
d = {v: float('inf') for v in g}         # Дейкстра из 1 во все вершины
d[1] = 0
q = [(0, 1)]
while q:
    dv, v = heapq.heappop(q)
    if dv > d[v]:
        continue
    for u, w in g[v]:
        if dv + w < d[u]:
            d[u] = dv + w
            heapq.heappush(q, (d[u], u))
best = max((d[v], v) for v in g if d[v] < float('inf'))
print(best[1])                           # номер самой удалённой вершины
Второй способ — рекурсия по обратному графу: $f(v)$ — длина кратчайшего пути из $1$ в $v$ — равна минимуму по всем предшественникам $a$ вершины $v$ величины $f(a) + w(a, v)$, база $f(1) = 0$. Это та же динамика, что раньше, но «задом наперёд»:
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
r = {}                                   # обратный граф
verts = set()
for line in open('23_13.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    r.setdefault(b, []).append((a, w))
    verts |= {a, b}
@lru_cache(None)
def f(v):                                # кратчайший путь 1 -> v
    if v == 1:
        return 0
    best = float('inf')
    for a, w in r.get(v, []):|
        best = min(best, f(a) + w)
    return best
print(max((f(v), v) for v in verts if f(v) < float('inf'))[1])
Длина кратчайшего пути из $1$ в $266$ равна $19374,6$; из вершины $1$ достижимы $47$ вершин из $50$; для сравнения, расстояние до вершины $100$ равно $12317,6$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество вершин графа, лежащих хотя бы на одном пути из вершины с номером $1$ в вершину с номером $100$ (сами вершины $1$ и $100$ также учитываются). Существование хотя бы одного такого пути гарантируется.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера на путях из вершины $1$ в вершину $100$ лежат вершины $1, 7, 4$ и $100$, а вершины $6$ и $12$ не лежат ни на одном таком пути, поэтому верным ответом будет $4$.
Вершина лежит на каком-нибудь пути из $1$ в $100$ тогда и только тогда, когда она достижима из $1$ и из неё достижима вершина $100$. Первое множество даёт обход прямого графа из вершины $1$, второе — обход обратного графа из вершины $100$; ответ — размер пересечения. Веса не нужны; ацикличность гарантирует, что путь «$1 → v$» и путь «$v → 100$» не пересекаются и склеиваются в один путь.
g = {}                                   # прямой граф
r = {}                                   # обратный граф
for line in open('23_14.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # веса не нужны
    g.setdefault(a, []).append(b)
    r.setdefault(b, []).append(a)
def reach(adj, start):                   # вершины, достижимые из start по adj
    seen = {start}
    stack = [start]
    while stack:
        v = stack.pop()
        for u in adj.get(v, []):
            if u not in seen:
                seen.add(u)
                stack.append(u)
    return seen
print(len(reach(g, 1) & reach(r, 100)))  # достижимы из 1 И ведут в 100
Второй способ — через счётчики путей из предыдущих заданий: $v$ лежит на пути, если число путей $1 → v$ и число путей $v → 100$ оба положительны. Продолжение программы после чтения графа:
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
def cnt(src, dst):                       # число путей src -> dst
    @lru_cache(None)
    def f(v):
        if v == dst:
            return 1
        return sum(f(u) for u in g.get(v, []))
    return f(src)
verts = set(g) | set(r)
print(sum(1 for v in verts if cnt(1, v) > 0 and cnt(v, 100) > 0))
Из вершины $1$ достижимы $46$ вершин, в вершину $100$ ведут пути из $44$ вершин, и та и другая достижимость есть у $40$ вершин (включая $1$ и $100$); всего в графе $50$ вершин.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе наименьшее количество рёбер, из которых может состоять путь из вершины с номером $1$ в вершину с номером $100$. Существование хотя бы одного такого пути гарантируется.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера верным ответом будет $1$: путь $1–100$ состоит из одного ребра (веса рёбер в этом вопросе не учитываются).
Это кратчайший путь в графе, где каждое ребро весит $1$: веса из файла не читаются, а в переходе вместо $w + f(u)$ стоит $1 + f(u)$. Второй способ — поиск в ширину: при обходе по слоям первое посещение вершины происходит по пути с наименьшим числом рёбер.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список соседей
for line in open('23_15.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # вес ребра не нужен
    g.setdefault(a, []).append(b)
@lru_cache(None)
def f(v):                                # наименьшее число рёбер v -> 100
    if v == 100:
        return 0
    best = float('inf')
    for u in g.get(v, []):
        best = min(best, 1 + f(u))       # каждое ребро «весит» 1
    return best
print(f(1))
Второй способ — поиск в ширину (продолжение после чтения графа):
from collections import deque
dist = {1: 0}                            # поиск в ширину из вершины 1
q = deque([1])
while q:
    v = q.popleft()
    for u in g.get(v, []):
        if u not in dist:                # первое посещение — кратчайшее
            dist[u] = dist[v] + 1
            q.append(u)
print(dist[100])
Путей из пяти рёбер в этом файле пять (совпадение с ответом случайно). Кратчайший по сумме весов путь (длина $12607,9$) состоит из $6$ рёбер, самый длинный по числу рёбер путь — из $26$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Для каждой вершины, отличной от вершин с номерами $1$ и $100$, подсчитаем количество различных путей из вершины $1$ в вершину $100$, проходящих через эту вершину. Найдите вершину, для которой это количество наибольшее. Гарантируется, что такая вершина единственная. В ответе запишите номер этой вершины. Два пути считаются различными, если они отличаются хотя бы одним ребром.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера для пары вершин $1$ и $100$ через вершины $7$ и $4$ проходит по одному пути, и условие единственности не выполнено. Для пары вершин $6$ и $12$ через вершину $100$ проходят все четыре пути, через вершину $1$ — три, через $7$ — два, через $4$ — один, поэтому ответом для этой пары была бы вершина $100$.
Число путей из $1$ в $100$ через вершину v равно произведению (число путей $1 → v$) × (число путей $v → 100$) — как в задании $5$. Достаточно посчитать это произведение для каждой вершины и выбрать наибольшее; функция подсчёта с запоминанием объявляется внутри cnt, поэтому для каждой пары (src, dst) кэш свой.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список соседей
for line in open('23_16.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b = int(s[0]), int(s[1])          # вес ребра не нужен
    g.setdefault(a, []).append(b)
def cnt(src, dst):                       # число путей src -> dst
    @lru_cache(None)
    def f(v):
        if v == dst:
            return 1
        return sum(f(u) for u in g.get(v, []))
    return f(src)
verts = set(g)                           # все вершины графа
for v in g:
    verts |= set(g[v])
best = max((cnt(1, v) * cnt(v, 100), v) for v in verts if v not in (1, 100))
print(best[1])                           # номер вершины
Второй способ — через вычитание: путей через v столько же, сколько всего минус минуя v (продолжение после определения verts):
def cnt_ban(banned):                     # число путей 1 -> 100, минуя banned
    @lru_cache(None)
    def f(v):
        if v == banned:
            return 0
        if v == 100:
            return 1
        return sum(f(u) for u in g.get(v, []))
    return f(1)
total = cnt_ban(None)
best = max((total - cnt_ban(v), v) for v in verts if v not in (1, 100))
print(best[1])
Через вершину $666$ проходит $458 091$ путь из $574 015$; на втором месте вершина $732$ ($355 564$ пути), на третьем — $29$ ($335 988$).
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе количество различных путей из вершины с номером $1$ в вершину с номером $100$, длина которых не превосходит $93$. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь. Два пути считаются различными, если они отличаются хотя бы одним ребром.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при ограничении «не превосходит $11$» верным ответом будет $2$ (пути $1–7–100$ длиной $7,5$ и $1–4–100$ длиной $10,5$), а при ограничении «не превосходит $12$» — $3$.
У функции два параметра, но теперь второй — оставшийся «бюджет» длины: $f(v, rest)$ — число путей из $v$ в $100$ длиной не более rest. Переход: $f(v, rest) = Σ f(u, rest − w)$. Базы в строгом порядке: сначала «бюджет отрицателен — путей нет», затем «мы в $100$ — один путь». Если проверить $v == 100$ первой, путь, пришедший в $100$ с перерасходом, будет засчитан. Веса целые, поэтому различных значений rest не больше $X + 1$, и запоминание работает.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_17.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
X = 93
@lru_cache(None)
def f(v, rest):                          # число путей v -> 100 длиной <= rest
    if rest < 0:                         # бюджет исчерпан — проверяем ПЕРВЫМ
        return 0
    if v == 100:
        return 1
    return sum(f(u, rest - w) for u, w in g.get(v, []))
print(f(1, X))
Второй способ — функция «число путей длиной ровно rest» из задания $10$, просуммированная по всем длинам от $0$ до $X$:
@lru_cache(None)
def e(v, rest):                          # число путей v -> 100 длины rest
    if v == 100:
        return 1 if rest == 0 else 0
    return sum(e(u, rest - w) for u, w in g.get(v, []) if rest - w >= 0)
print(sum(e(1, L) for L in range(X + 1)))   # веса целые: длины 0, 1, ..., X
Из них $14$ путей имеют длину ровно $93$ и $198$ — меньше $93$. Кратчайший путь имеет длину $42$, всего путей $1 → 100$ в файле $5 305 347$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины второго по длине пути из вершины с номером $1$ в вершину с номером $100$, то есть кратчайшего среди всех путей, отличных от кратчайшего. Гарантируется, что кратчайший путь единственный и что существует хотя бы один другой путь. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера длины путей равны $7,5$ ($1–7–100$), $10,5$ ($1–4–100$) и $12,0$ ($1–100$); второй по длине путь имеет длину $10,5$, поэтому верным ответом будет $10$.
Функция возвращает две лучшие длины: $f(v) = (l1, l2)$ — кратчайший и второй по длине пути из $v$ в $100$. Кандидаты для $v$ — продолжения через каждого соседа $u$ как лучшего, так и второго пути из $u$: $w + l1(u)$ и $w + l2(u)$. Из всех кандидатов берутся два наименьших. Второй путь из $v$ может отличаться от кратчайшего либо первым ребром, либо продолжением после него — оба случая учтены. База: из вершины $100$ ровно один (пустой) путь, второго нет — ($0, +∞$).
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_18.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
INF = float('inf')
@lru_cache(None)
def f(v):                                # (кратчайший, второй) путь v -> 100
    if v == 100:
        return (0, INF)                  # из 100 в 100 путь один
    cand = []
    for u, w in g.get(v, []):
        a, b = f(u)
        cand.append(w + a)               # продолжить лучший путь потомка
        cand.append(w + b)               # ...или второй по длине
    cand.sort()
    cand += [INF, INF]                   # если кандидатов меньше двух
    return (cand[0], cand[1])
print(int(f(1)[1]))
Второй способ — через удаление рёбер: второй по длине путь отличается от кратчайшего хотя бы одним ребром, поэтому он равен минимуму по всем рёбрам кратчайшего пути от длины кратчайшего пути без этого ребра (продолжение после определения INF):
@lru_cache(None)
def sp(v):                               # (длина, кортеж вершин) кратчайшего
    if v == 100:
        return (0, (100,))
    best = (INF, ())
    for u, w in g.get(v, []):
        L, p = sp(u)
        best = min(best, (w + L, (v,) + p))
    return best
L1, path = sp(1)
best = INF
for i in range(len(path) - 1):
    a, b = path[i], path[i + 1]          # запрещаем ребро a -> b
    @lru_cache(None)
    def d(v):                            # кратчайший путь без ребра a -> b
        if v == 100:
            return 0
        return min([w + d(u) for u, w in g.get(v, [])
                    if not (v == a and u == b)], default=INF)
    best = min(best, d(1))
print(int(best))
Кратчайший путь $1 → 889 → 856 → 225 → 806 → 4 → 842 → 100$ имеет длину $12720,4$; второй по длине путь $1 → 889 → 856 → 225 → 291 → 312 → 842 → 100$ — длину $12724,7$.
20
В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$, проходящего через обе вершины с номерами $187$ и $769$ (порядок, в котором путь проходит эти вершины, не задан). Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера для пары вершин $1$ и $100$ пути, проходящего через обе вершины $7$ и $4$, не существует. Для пары вершин $6$ и $12$ при условии прохождения через вершины $1$ и $7$ верным ответом было бы $9$: единственный такой путь $6–1–7–100–12$ имеет длину $9,5$.
Путь через обе вершины $K$ и $M$ проходит их в каком-то порядке: либо $1 → K → M → 100$, либо $1 → M → K → 100$. Каждый вариант — сумма трёх кратчайших отрезков, как в задании $4$; в ациклическом графе не более одного из вариантов осуществим (если есть путь $K → M$, то пути $M → K$ нет), поэтому ответ — минимум из двух сумм, одна из которых равна $+∞$.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_19.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
def short(src, dst):                     # длина кратчайшего пути src -> dst
    @lru_cache(None)
    def f(v):
        if v == dst:
            return 0
        best = float('inf')
        for u, w in g.get(v, []):
            best = min(best, w + f(u))
        return best
    return f(src)
K, M = 187, 769
a = short(1, K) + short(K, M) + short(M, 100)   # сначала K, потом M
b = short(1, M) + short(M, K) + short(K, 100)   # сначала M, потом K
print(int(min(a, b)))                    # один из вариантов равен inf
Второй способ — три запуска алгоритма Дейкстры (из $1$, из $K$ и из $M$):
import heapq
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_19.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
    g.setdefault(b, [])                  # все вершины — ключи словаря
def dijkstra(src):                       # расстояния от src до всех вершин
    d = {v: float('inf') for v in g}
    d[src] = 0
    q = [(0, src)]
    while q:
        dv, v = heapq.heappop(q)
        if dv > d[v]:
            continue
        for u, w in g[v]:
            if dv + w < d[u]:
                d[u] = dv + w
                heapq.heappush(q, (d[u], u))
    return d
K, M = 187, 769
d1, dK, dM = dijkstra(1), dijkstra(K), dijkstra(M)
print(int(min(d1[K] + dK[M] + dM[100], d1[M] + dM[K] + dK[100])))
Верный порядок — сначала $769$, потом $187$; длина $24461,7$; путь $1 → 662 → 36 → 68 → 628 → 769 → 992 → 685 → 187 → 758 → 307 → 100$ ($11$ рёбер). Вариант «сначала $187$» невозможен: из $187$ вершина $769$ недостижима.
20