
 Карточки
 Тесты


 Главная
 Курсы
 Подписка
23. Алгоритмические задачи, связанные с анализом графов: #313125

В текстовом файле содержится описание ациклического ориентированного взвешенного графа.
В каждой строке файла записаны два натуральных числа ($L, M$) и одно положительное вещественное число ($W$). $L, M$ — номера вершин графа, $W$ — вес ребра, ведущего из вершины $L$ в вершину $M$. Таким образом, количество строк в файле равно количеству рёбер в графе. Две вершины графа не могут быть соединены более чем одним ребром.
Найдите и запишите в ответе целую часть длины кратчайшего пути из вершины с номером $1$ в вершину с номером $100$, состоящего не более чем из $5$ рёбер. Существование хотя бы одного такого пути гарантируется. Под длиной пути понимается сумма весов рёбер, составляющих путь.
Для выполнения этого задания следует написать программу.
Вершины графа могут быть пронумерованы не подряд. $L ≤ 1000, M ≤ 1000; W ≤ 10 000$. Количество строк в файле не превосходит $200$. Числа в строках разделены произвольным ненулевым количеством пробелов и/или табуляций.
Типовой пример организации данных во входном файле для графа на рисунке
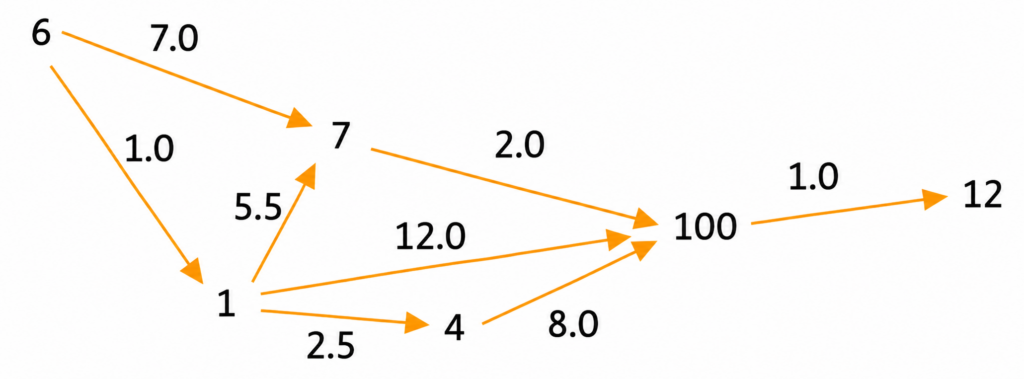
| 100 6 6 1 7 4 1 1 | 12 7 1 7 100 100 100 4 | 1.0 7.0 1.0 5.5 2.0 8.0 12.0 2.5 |
Для приведённого примера при ограничении «не более чем из $1$ ребра» верным ответом будет $12$ (единственный такой путь $1–100$), а при ограничении «не более чем из $2$ рёбер» — $7$ (кратчайший из путей $1–100, 1–7–100, 1–4–100$ имеет длину $7,5$).
У функции два параметра: $f(v, k)$ — длина кратчайшего пути из $v$ в $100$, использующего не более $k$ рёбер. Переход: $f(v, k) = min(w + f(u, k − 1))$ по рёбрам $v → u$. Порядок баз важен: сначала «мы в $100$ — путь найден, остаток рёбер не имеет значения», и только потом «рёбра кончились — пути нет». Если поменять их местами, пути ровно из $N$ рёбер будут отброшены.
from functools import lru_cache
import sys
sys.setrecursionlimit(10000)
g = {}                                   # вершина -> список (сосед, вес)
for line in open('23_11.txt'):
    s = line.split()                     # любые пробелы и табуляции
    if len(s) < 3:                       # пустая строка
        continue
    a, b, w = int(s[0]), int(s[1]), float(s[2])
    g.setdefault(a, []).append((b, w))
N = 5
@lru_cache(None)
def f(v, k):                             # кратчайший v -> 100, <= k рёбер
    if v == 100:                         # дошли: остаток рёбер не важен
        return 0
    if k == 0:                           # рёбра кончились, а мы не в 100
        return float('inf')
    best = float('inf')
    for u, w in g.get(v, []):
        best = min(best, w + f(u, k - 1))
    return best
print(int(f(1, N)))
Второй способ — $N$ раундов релаксации рёбер (алгоритм Беллмана–Форда): после $i$ раундов $d[v]$ равно длине кратчайшего пути в $v$ не более чем из $i$ рёбер, если каждый раунд использует расстояния только предыдущего раунда:
edges = []
for line in open('23_11.txt'):
    s = line.split()
    if len(s) < 3:
        continue
    edges.append((int(s[0]), int(s[1]), float(s[2])))
N = 5
d = {1: 0}                               # расстояния путями <= i рёбер
for i in range(N):
    nd = dict(d)                         # раунд i+1 — по итогам раунда i
    for a, b, w in edges:
        if a in d and d[a] + w < nd.get(b, float('inf')):
            nd[b] = d[a] + w
    d = nd
print(int(d[100]))
Длина $18555,6$; путь $1 → 767 → 78 → 55 → 62 → 100$ (ровно $5$ рёбер). Безусловный кратчайший путь имеет длину $13687,7$ и состоит из $6$ рёбер; лучший путь не более чем из $4$ рёбер имеет длину $23290,9$.
 20
