
 Карточки
 Тесты


 Главная
 Курсы
 Подписка
27. Программирование: #299494

Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на $N$ непересекающихся непустых подмножеств (кластеров), таких, что точки каждого подмножества лежат внутри квадрата со стороной длиной $H$, причём эти квадраты между собой не пересекаются. Стороны квадрата не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров квадрата.
В ответе запишите четыре числа через запятую: сначала целую часть произведения $|P_x| \times 10,000$, затем целую часть произведения $|P_y| \times 10,000$ для файла $А$, далее — аналогичные данные для файла $Б$.
Возможные данные одного из файлов иллюстрированы графиком. Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемого файла.
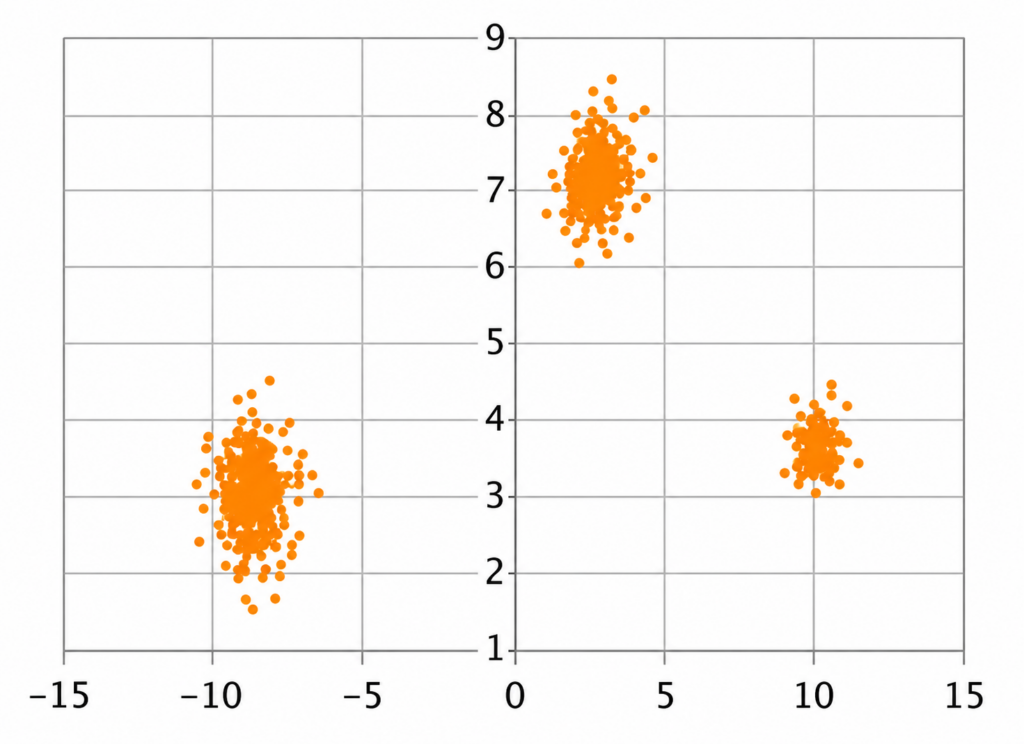
Центр здесь определяется через сумму расстояний — это точка самого кластера, ищем её перебором, а не как среднее арифметическое координат. Обратите внимание, что $P_x$ и $P_y$ — уже обычные средние арифметические, но не по всем точкам, а только по найденным центрам.
Кластеризация. Квадраты не пересекаются, поэтому кластеры разделены в пространстве. Разбиваем точки на компоненты связности, но порог здесь нужно подбирать особенно внимательно, потому что файл $А$ очень разрежен: в нём всего $99$ точек, разбросанных по областям размером около $5 \times 5$. При пороге $1{,}0$ он рассыпается на семь кусков, и только начиная с $2{,}0$ остаются ровно две группы — $50$ и $49$ точек. В файле $Б$ точек много ($9916$), там сгустки плотные и результат устойчив начиная с $1{,}0$: три группы по $3313$, $3306$ и $3297$ точек.
Проверяем допустимость: в файле $А$ группы занимают области примерно $5{,}3 \times 4{,}8$ и $4{,}8 \times 5{,}6$ — обе умещаются в квадрат со стороной $6$ (напомню, стороны квадрата не обязаны быть параллельны осям, так что габариты по осям — лишь грубая оценка сверху). В файле $Б$ области около $7{,}2 \times 7{,}4$, $6{,}6 \times 6{,}8$ и $7{,}4 \times 7{,}1$ при допустимой стороне $8$. Число кластеров совпадает с условием.
import zipfile, math
from xml.etree import ElementTree as ET

T = '{urn:oasis:names:tc:opendocument:xmlns:table:1.0}'
O = '{urn:oasis:names:tc:opendocument:xmlns:office:1.0}'

def load(name):
    x = ET.fromstring(zipfile.ZipFile(name).read('content.xml'))
    P = []
    for r in x.iter(T + 'table-row'):
        parts = []
        for c in r.iter(T + 'table-cell'):
            v = c.get(O + 'value') or ''.join(c.itertext()).strip()
            if v: parts.append(v)
        tok = ' '.join(parts).replace(',', '.').split()
        if len(tok) < 2: continue
        try: P.append((float(tok[0]), float(tok[1])))
        except ValueError: pass
    return P

def center(c):
    return min(c, key=lambda a: sum(math.dist(a, b) for b in c))

def clusters(pts, eps):
    unused, res = set(range(len(pts))), []
    while unused:
        i = unused.pop(); comp, stack = [i], [i]
        while stack:
            a = stack.pop()
            for j in list(unused):
                if math.dist(pts[a], pts[j]) < eps:
                    unused.discard(j); comp.append(j); stack.append(j)
        res.append([pts[k] for k in comp])
    return res

for name, eps in [('27-24_A.ods', 2.0), ('27-24_B.ods', 1.0)]:
    cs = [center(c) for c in clusters(load(name), eps)]
    Px = sum(p[0] for p in cs) / len(cs)
    Py = sum(p[1] for p in cs) / len(cs)
    print(int(abs(Px) * 10000), int(abs(Py) * 10000))
Результаты для файла $А$. Всего $99$ точек, два кластера по $50$ и $49$ точек. Первый занимает область $x \in [1{,}05;\ 6{,}33]$, $y \in [-5{,}09;\ -0{,}33]$, его центр — $(3{,}981033369;\ -1{,}961127579)$; второй занимает $x \in [-2{,}04;\ 2{,}71]$, $y \in [5{,}00;\ 10{,}64]$ с центром $(1{,}262277635;\ 6{,}797635538)$. Отсюда $P_x = 2{,}621655502$ и $P_y = 2{,}418253979$, что после умножения на $10,000$ и отбрасывания дробной части даёт $26216$ и $24182$.
Результаты для файла $Б$. Всего $9916$ точек, три кластера по $3313$, $3306$ и $3297$ точек с центрами $(25{,}20349762;\ -0{,}833550091)$, $(4{,}309073189;\ 6{,}615238685)$ и $(15{,}75501912;\ 13{,}34466476)$. Отсюда $P_x = 15{,}089196643$ и $P_y = 6{,}375451118$, что даёт $150891$ и $63754$.
 20
